第17章 高级数据表示
本页最后更新于 ,内容可能过时
结构数组改用动态数组
示例
#include <stdio.h>
#include <stdlib.h>
#define TSIZE 45
struct film {
    char title[TSIZE];
    int rating;
};
int main(void)
{
    int n, i;
    struct film * movies;
    printf("Enter the number of movies:\n");
    if (scanf("%d", &n) != 1 || n <= 0)
        return 1;
    movies = (struct film *)
        malloc(n * sizeof(struct film));
    if (movies == NULL)
        return 1;
    for (i = 0; i < n; i++)
        movies[i].rating = 0;
    free(movies);
    return 0;
}
说明
- 元素个数在运行时由输入确定,编译时不再固定
- 分配成功后,
movies可按movies[i]访问,写法与数组名相同 malloc()返回void *,赋给结构指针前做强制类型转换- 分配失败返回
NULL,使用前必须检查 - 用完调用
free()释放整块内存 - 每项占用空间相同,适合一次分配整块
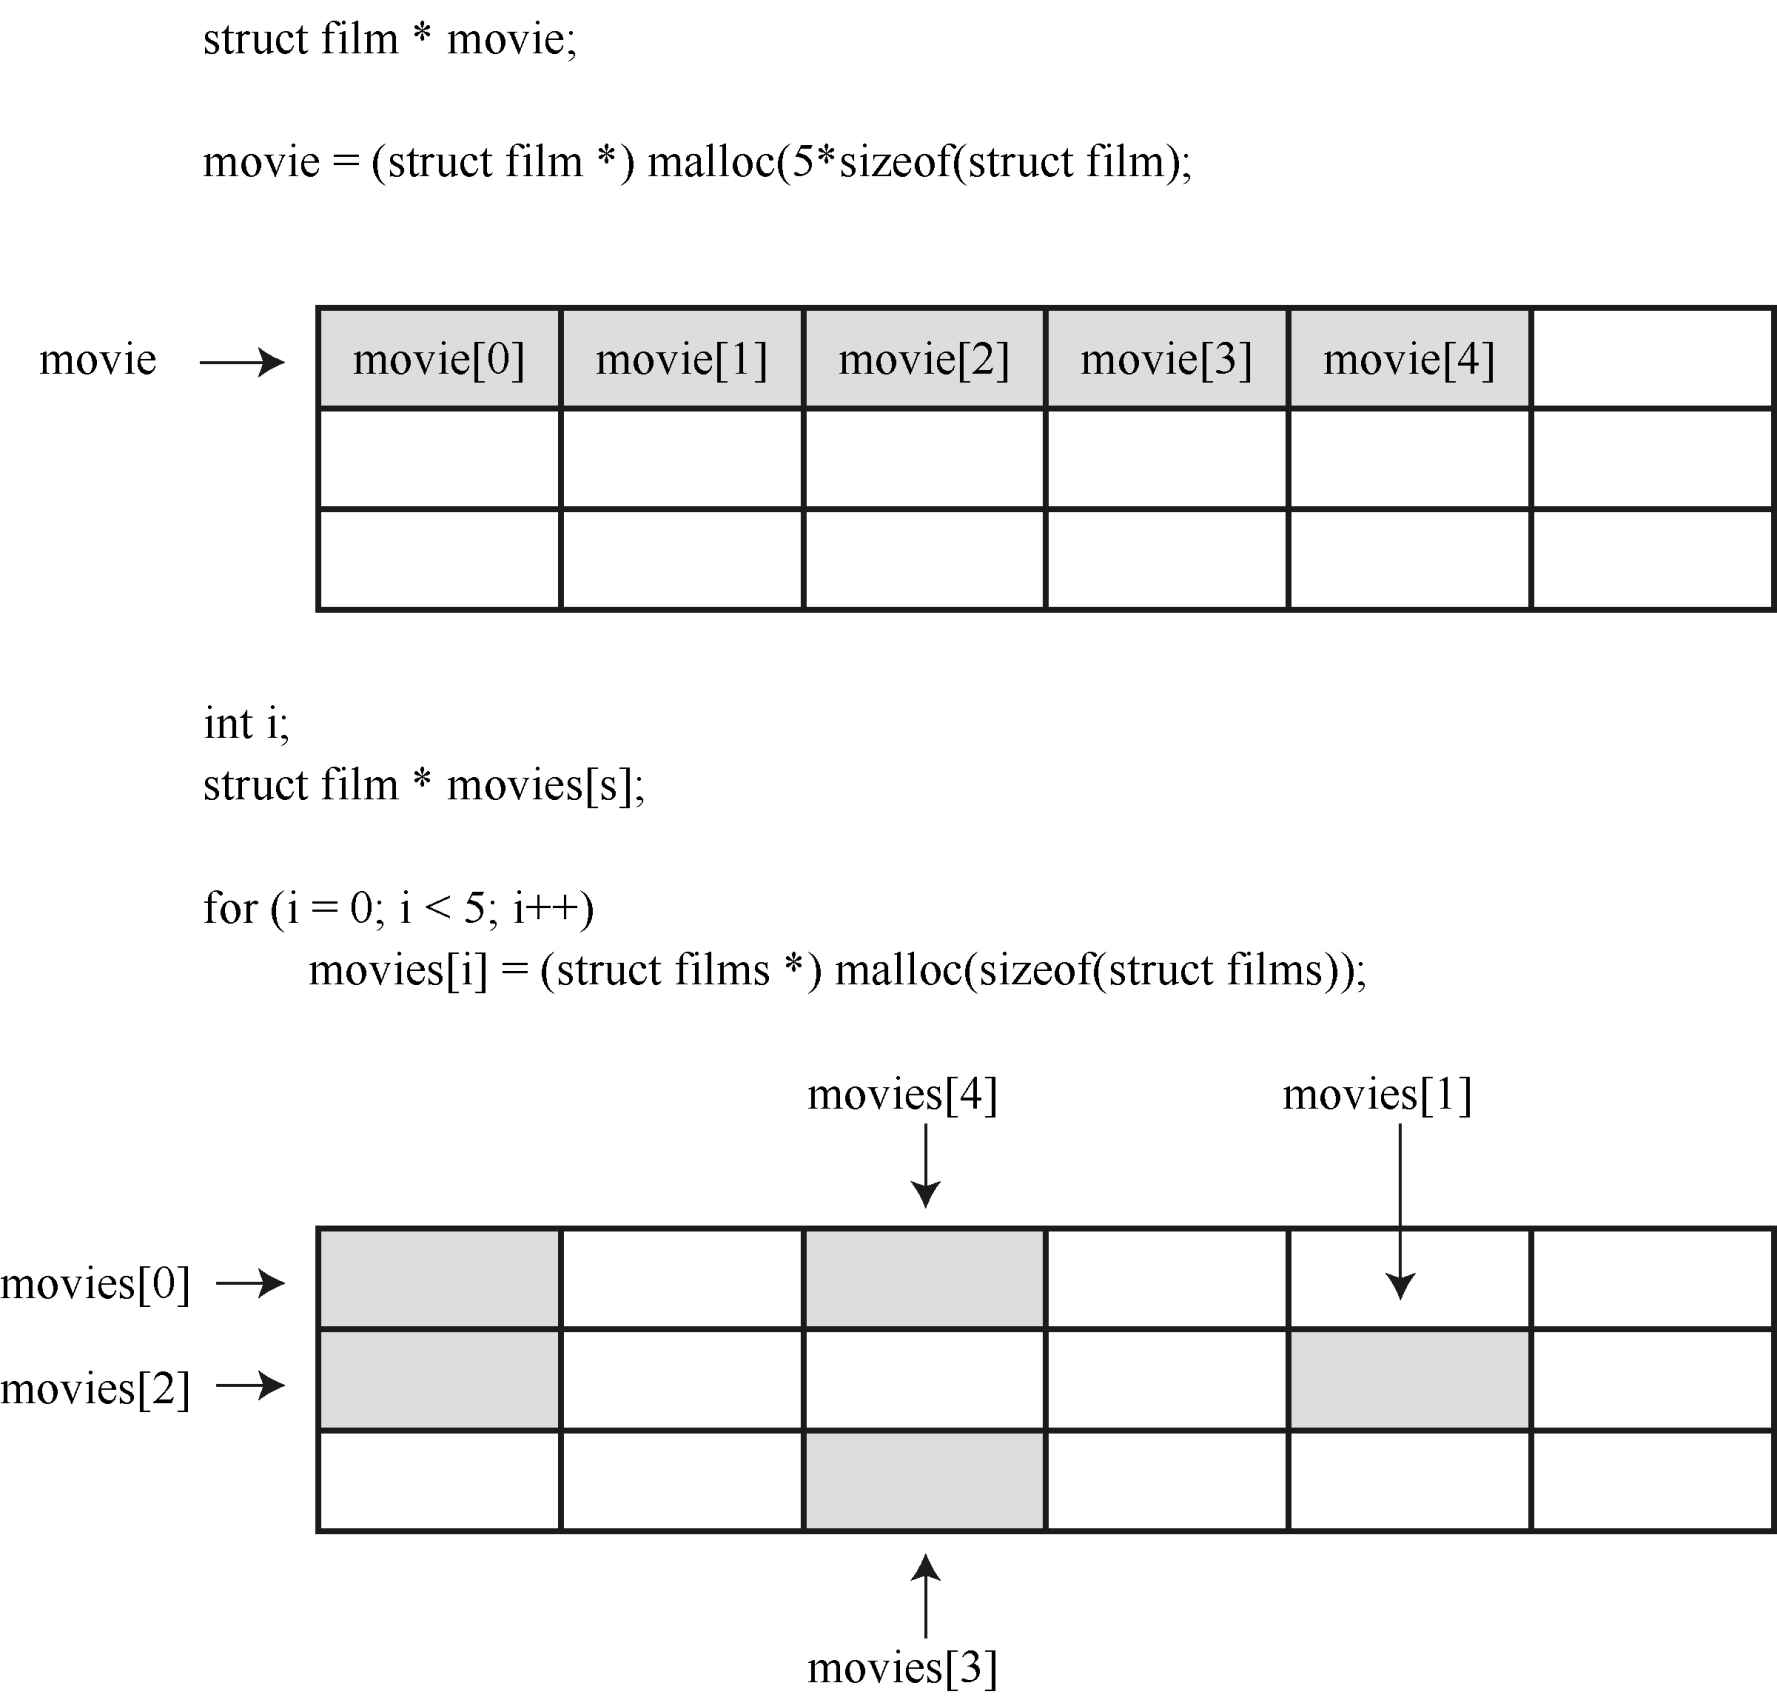
常见错误
- 不检查
malloc()的返回值 - 分配之后仍用
FMAX限制输入项数 - 忘记
free(),或在free()之后继续用movies访问元素
自引用结构
示例
说明
- 结构不能包含与自身类型相同的成员,可以包含指向自身类型的指针
- 指针成员存放下一项的地址,最后一项置为
NULL NULL定义在stdio.h等头文件中,表示空指针- 这种定义是链表的基础,每一项记录下一项的位置
- 另设一个头指针保存第一项的地址,链表由此进入
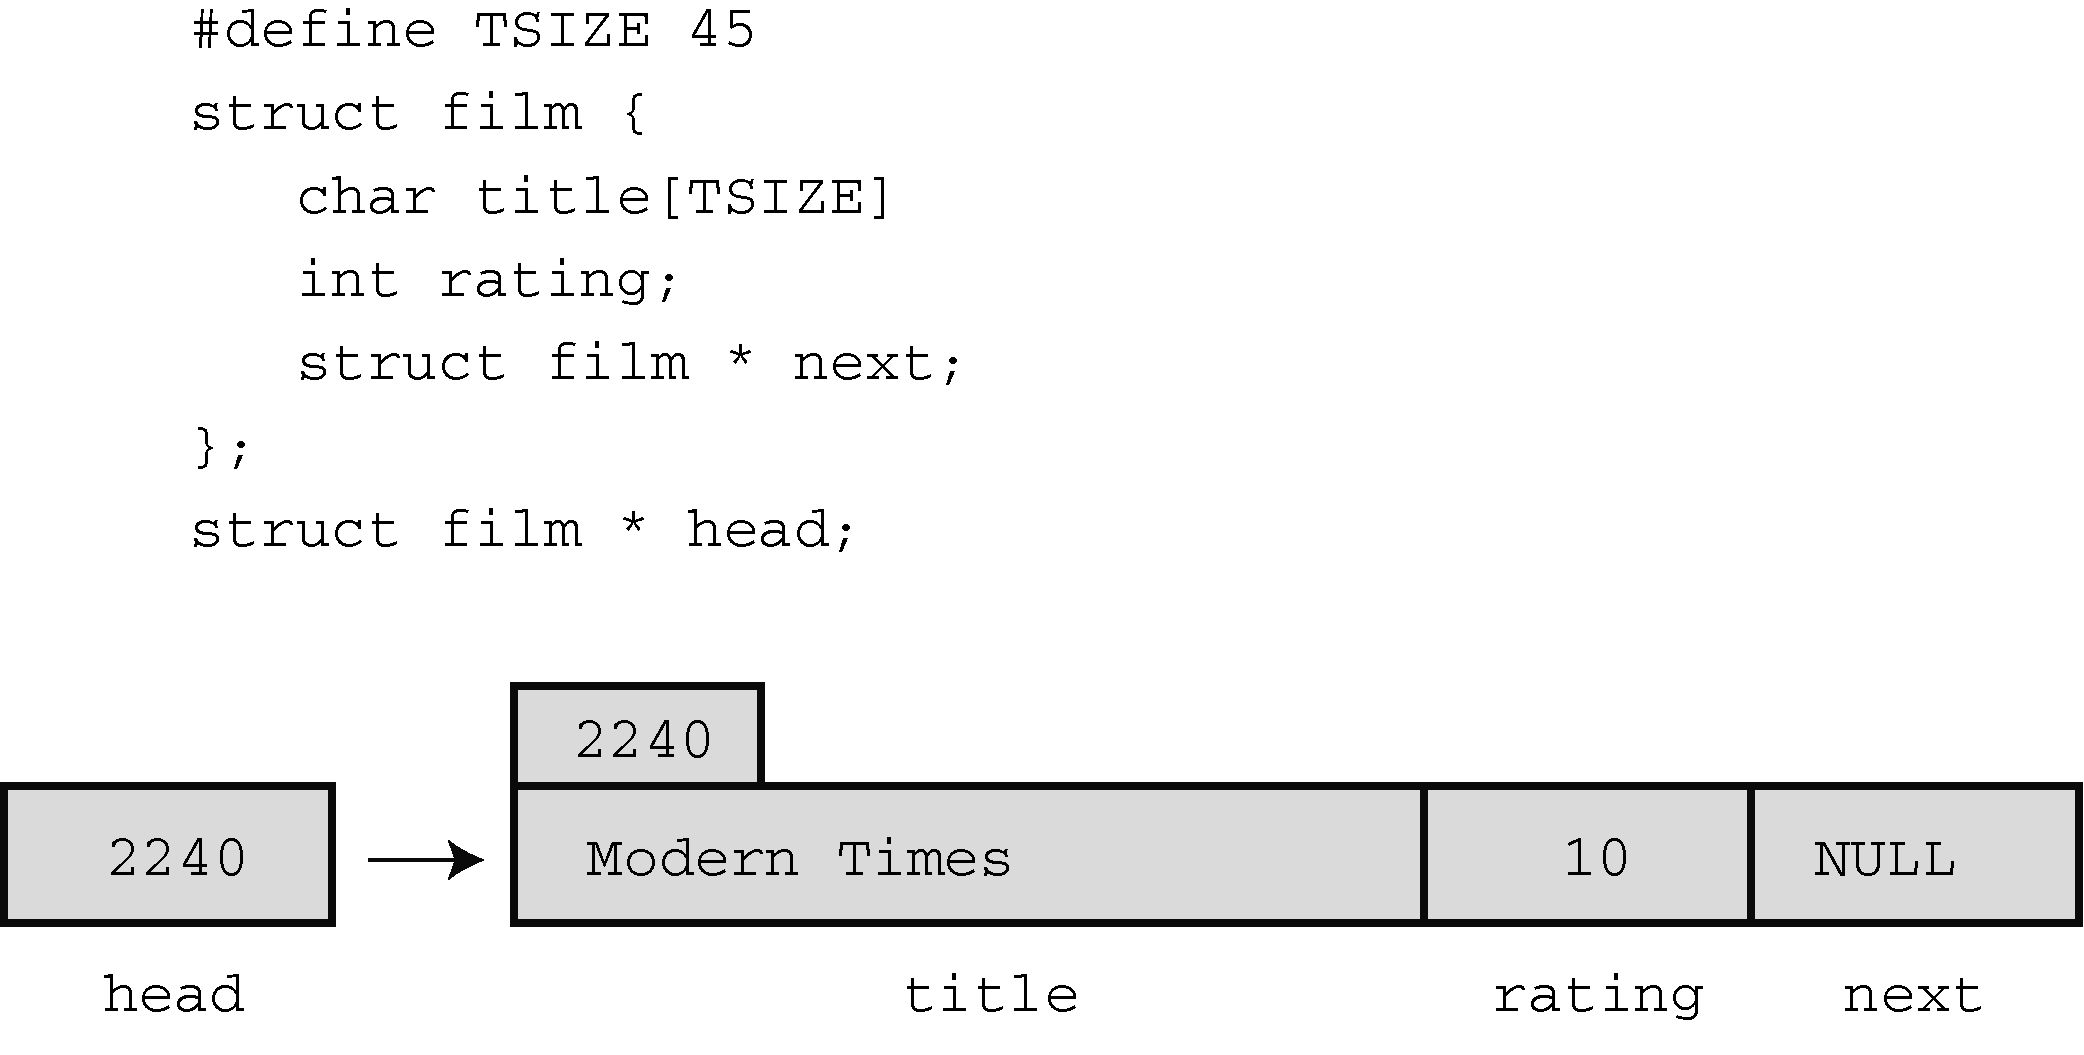
常见错误
- 写成
struct film next;,结构大小无法确定,编译失败 - 忘记把末项的
next置为NULL,遍历无法终止
链表遍历
示例
说明
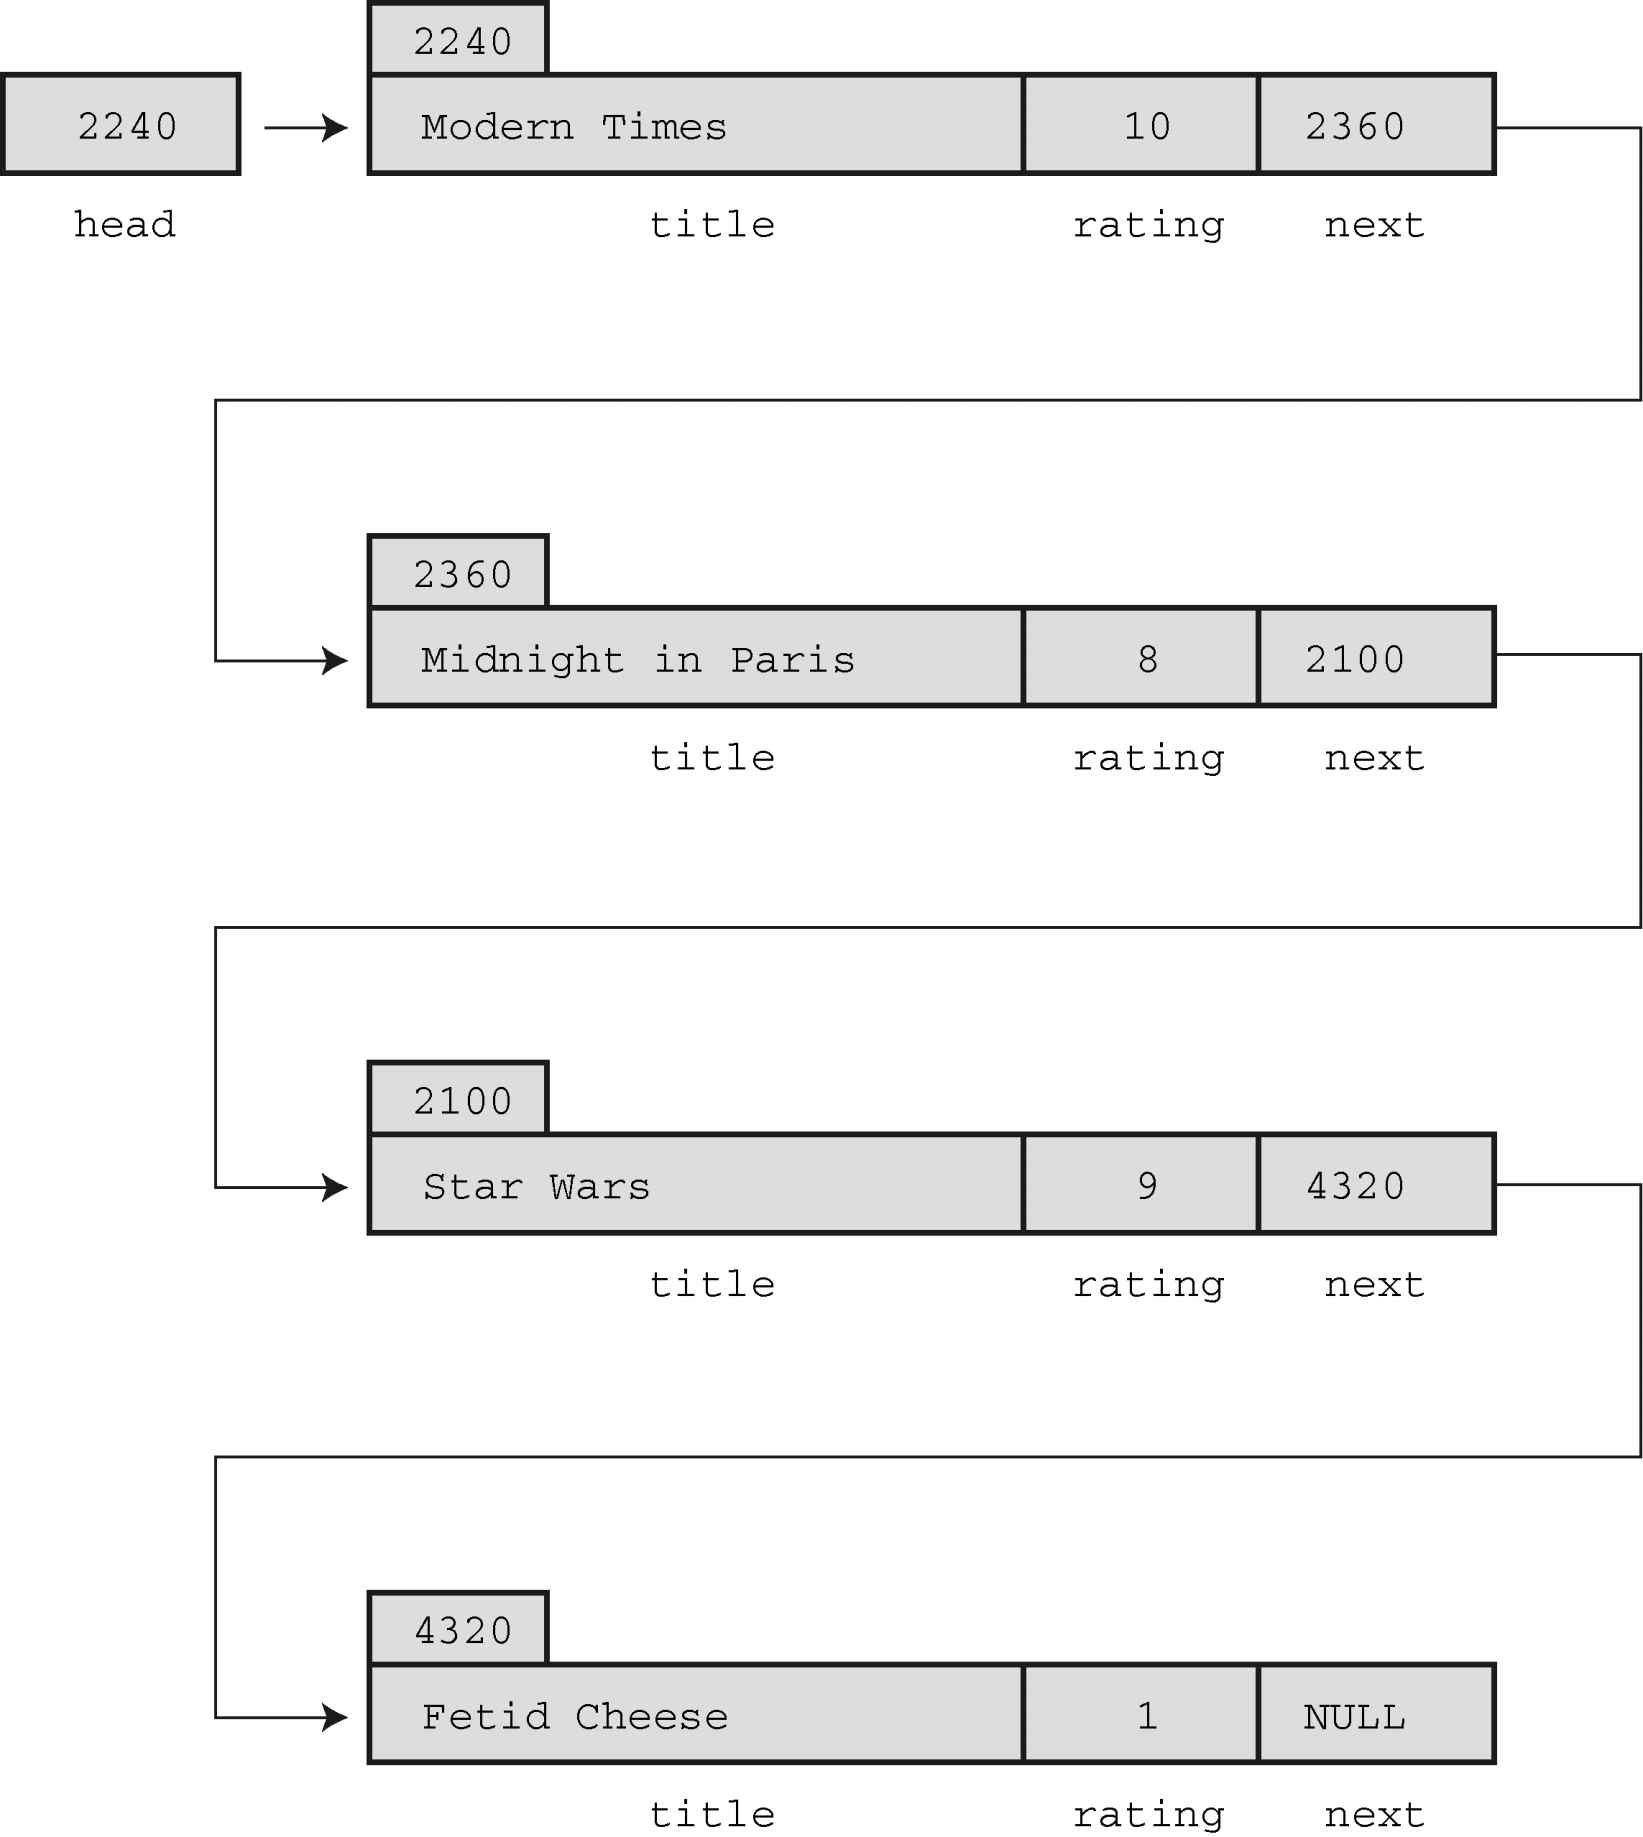
- 从头指针开始,每处理一项就沿
next前进一项 - 遍历必须用副本指针,直接改
head会丢失链表起点 - 链表只支持顺序访问,不能按下标跳转
- 显示,计数,查找都可以套用这一循环
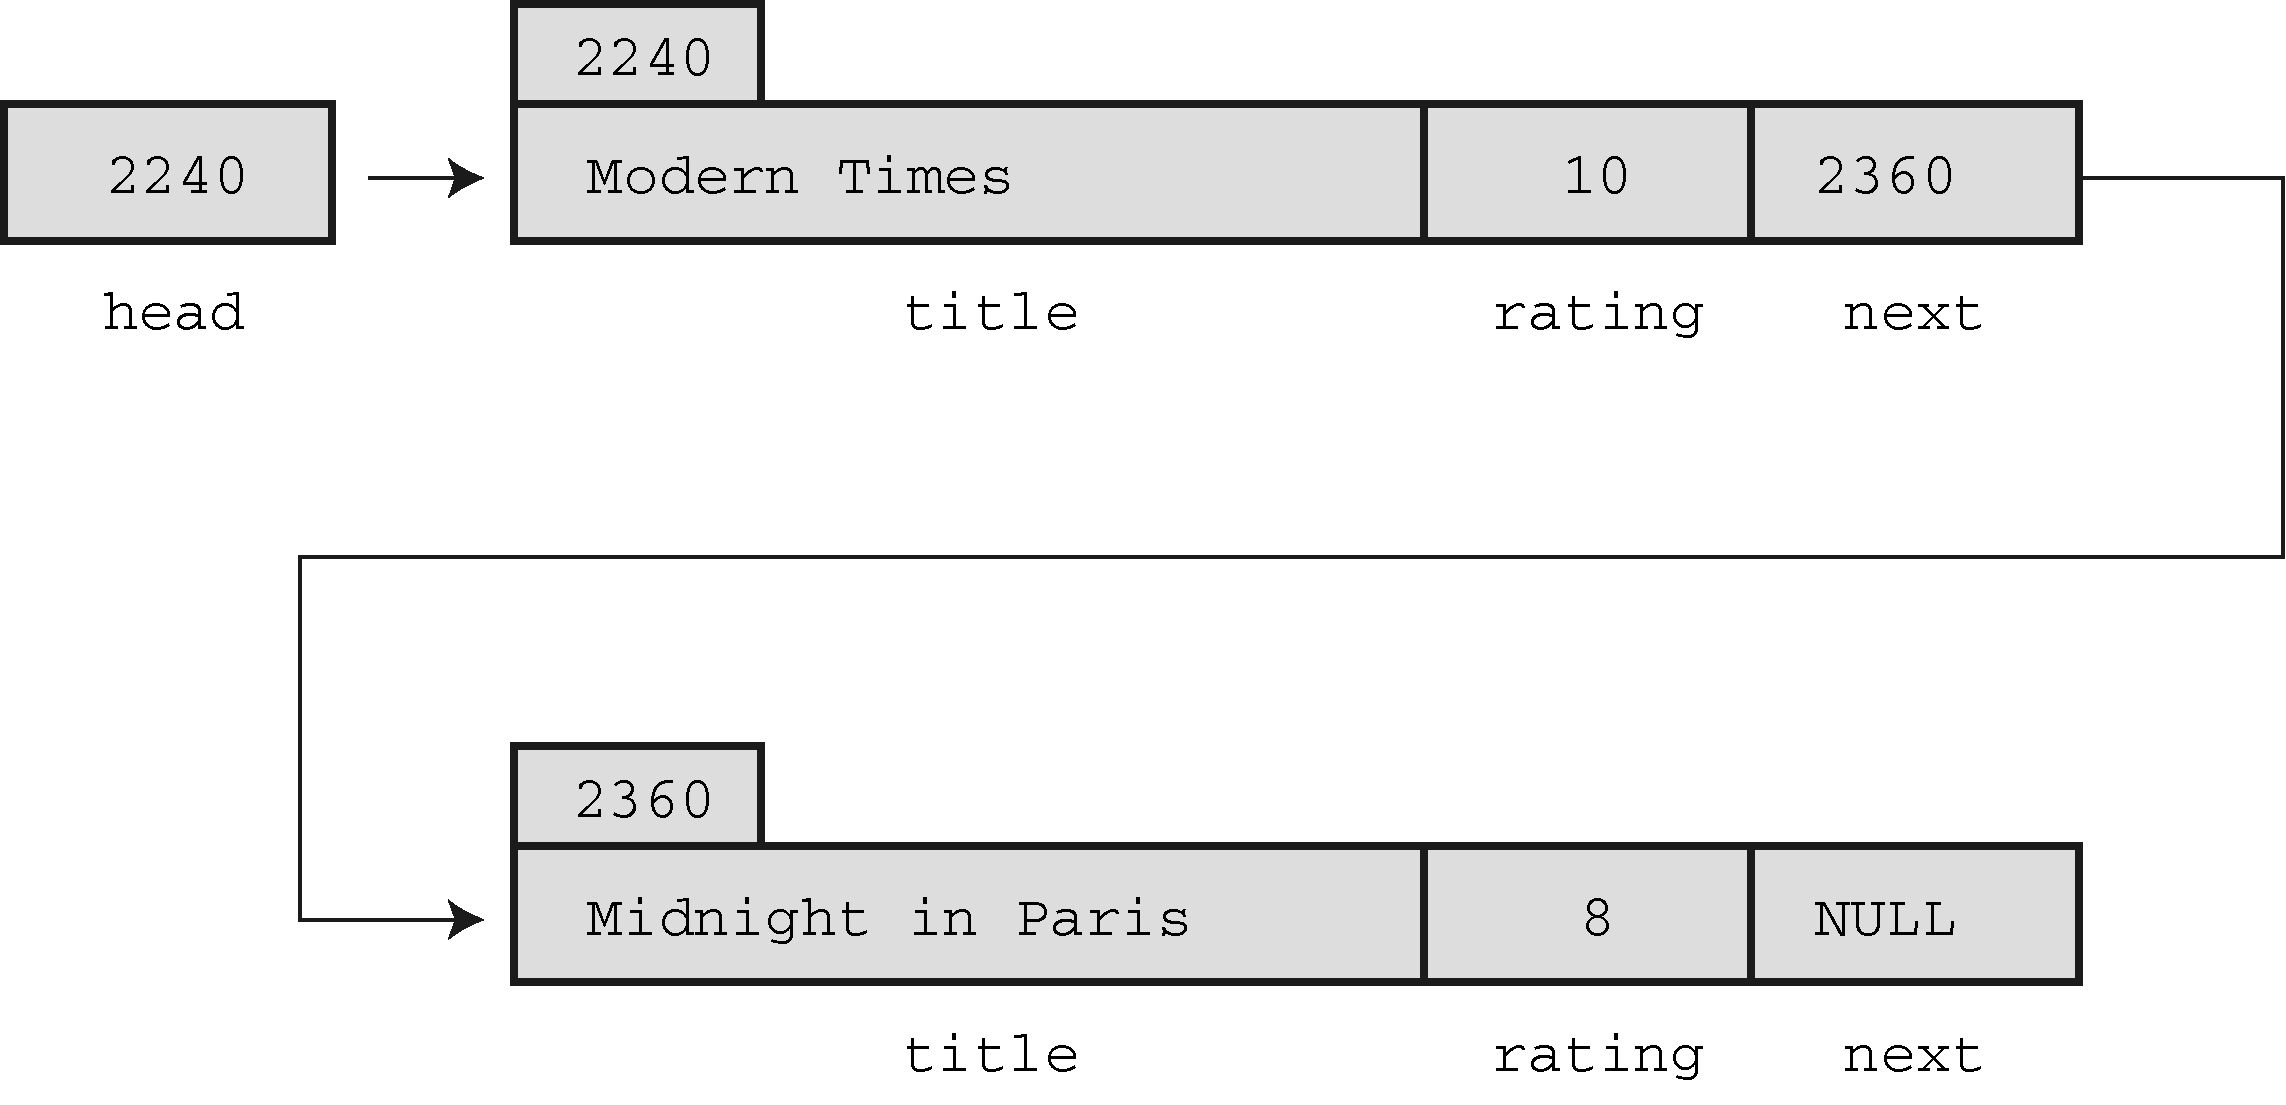
常见错误
- 用
head = head->next遍历,循环结束后链表起点丢失 - 先取
current->next再判断current,对空链表解引用NULL
链表尾插建表
语法形式
示例
说明
- 建表分三步: 分配空间,保存地址,拷贝数据
- 头指针初始化为
NULL,用head == NULL判断是否为第一项 prev指向上一次分配的节点,循环末尾更新- 新节点的
next先置NULL,后续插入时再改写 - 每输入一项调用一次
malloc(),项数不受编译期常量限制 - 在末尾追加需从头扫描到尾,时间复杂度为 \(O(n)\)
常见错误
- 在
malloc()之后不检查返回值 - 忘记
current->next = NULL,遍历越过链表末尾 - 忘记
prev = current,新节点接在错误位置
链表释放
示例
说明
free()只归还内存,不改变指针变量的值,也不把指针置空- 必须在
free()之前保存next,否则无法找到下一项 - 释放后原指针成为悬空指针,不应再解引用
- 逐个释放后把
head置为NULL,表示空链表
[程序清单17.2 的释放循环先 free 再读 next,顺序有误,此处按 17.2.1 节正文改写]
常见错误
- 先
free(current)再读current->next,属于 use-after-free - 只释放头节点,其余节点的内存泄漏
- 释放后继续用
head遍历
ADT 的三层结构
示例
/* list.h: 接口 */
typedef struct film Item;
typedef struct node {
    Item item;
    struct node * next;
} Node;
typedef Node * List;
void InitializeList(List * plist);

/* films3.c: 使用接口 */
#include "list.h"
List movies;
InitializeList(&movies);

/* list.c: 实现接口 */
#include "list.h"
void InitializeList(List * plist)
{
    *plist = NULL;
}
说明
- 抽象数据类型由属性和操作定义,不依赖具体实现
- 接口用头文件给出类型名与函数原型,附前提条件和后置条件注释
- 实现放在独立的源文件,使用接口的程序不接触内部细节
- 交换实现只改源文件,使用接口的程序不变
- 这种分离称为数据隐藏
常见错误
- 在使用接口的程序中直接操作内部指针,接口函数之间的约定被破坏
- 把结构定义的细节写进使用接口的程序
通用项类型与链表类型
语法形式
示例
说明
Item是链表储存的项,换数据形式时只改这一处- 链表中的一环称为节点,由项和
next指针组成 List是指向节点的指针类型,声明List movies即得到一个链表- 也可把
List定义为结构,内含头指针和项数,便于扩展 - 接口层不应假定
List的内部形式
常见错误
- 把
List当成节点而不是链表,在接口外写movies->item - 换
Item类型后,忘了重新编译所有使用该类型的文件
链表初始化与判空判满
语法形式
示例
说明
- 初始化需要修改链表变量,参数取
List *,调用写InitializeList(&movies) const List *限制的是*plist,不能改movies本身const不限制修改*plist指向的数据- 链表大小取决于可用内存,判满通过试分配一次实现
- 试分配成功后必须立即
free(),否则每次判满都泄漏
常见错误
- 直接写
movies = NULL,实现换成结构类型后失效 - 初始化之前调用
ListIsEmpty() - 判满时分配了内存却忘记释放
统计链表项数
语法形式
说明
- 用局部指针
pnode遍历,不改变头指针 - 链表不保存项数,每次统计都完整走一遍
- 若
List结构内含items成员,可直接返回该成员 - 返回类型取
unsigned int,项数不可能为负
常见错误
- 用
*plist = (*plist)->next遍历,改变了链表起点 - 认为统计结果可以代替遍历,在插入删除后沿用旧值
链表末尾添加项
示例
bool AddItem(Item item, List * plist)
{
    Node * pnew;
    Node * scan = *plist;

    pnew = (Node *) malloc(sizeof(Node));
    if (pnew == NULL)
        return false;
    pnew->item = item;
    pnew->next = NULL;
    if (scan == NULL)
        *plist = pnew;
    else
    {
        while (scan->next != NULL)
            scan = scan->next;
        scan->next = pnew;
    }
    return true;
}
说明
- 先分配节点,分配失败返回
false,此时链表不变 - 空链表时新节点就是头节点,直接赋给
*plist - 非空链表时扫描到
next为NULL的末节点,再接上新节点 - 调用方不必先判满,函数内部仍要检查
malloc() - 该实现每次从头部扫描,可另存尾指针改为 \(O(1)\)
常见错误
- 分配失败后仍继续写
pnew->item - 空链表与非空链表走同一分支,头指针没有赋值
- 新节点的
next未置NULL,链表与旧数据相连
遍历链表并应用函数
示例
说明
- 参数
pfun是指向函数的指针,该函数接收Item且无返回值 - 函数名本身代表函数地址,传参时直接写
showmovies - 链表中的每一项交给
pfun处理一次 - 遍历顺序由
next链决定,单向链表只能正序 - 同一接口可配合不同函数完成显示,统计,写入文件
常见错误
- 写成
pfun(item)而非(*pfun)(item),可读性差且易与解引用混淆 - 传入的函数的参数类型与
Item不一致,编译报错或行为未定义
释放整个链表
示例
说明
- 参数为
List *,因为函数要把链表变量重置为NULL List本身是指针,所以plist是指向指针的指针- 循环中先保存下一节点,再释放当前节点,最后前移
- 循环结束时
*plist为NULL,原链表变量成为空链表 - 释放后链表不能再使用,只能重新初始化
队列的类型定义
语法形式
说明
- 队列是先进先出结构,新项从末尾加入,从开头删除
front指向首项,rear指向末项,items记录项数Queue是结构而不是指针,传参用Queue *可避免复制- 上限
MAXQUEUE由接口确定,模拟场景中表示最多排队人数 Item由使用接口的程序定义,换成结构即可储存复杂数据
常见错误
- 只保存
front而不保存rear,入队要扫描整个链表 - 把
Queue直接按值传参,函数改不到原队列
队列的接口原型
语法形式
示例
说明
- 所有函数统一取队列地址作参数,调用形式一致
- 不修改队列的函数加
const,防止误改 - 出队把首项拷贝到
*pitem,返回值表示是否成功 DeQueue()直接返回Item的写法无法报告失败,不如返回bool- 前提条件与后置条件写在原型前的注释中
常见错误
- 出队函数只返回值而不报告队列为空
- 修改队列的函数漏掉指针参数,改动随函数返回丢失
队列初始化与状态查询
示例
说明
- 空队列的条件是首尾指针都为
NULL且items为0 - 判空,判满,计数都只读
items,时间均为 \(O(1)\) - 队列的项数由计数器单独维护,不必遍历链表
- 初始化必须在其他接口函数之前调用
常见错误
- 只置
items = 0,未清空两个指针,后续入队从旧地址续接
入队
示例
bool EnQueue(Item item, Queue * pq)
{
    Node * pnew;

    if (QueueIsFull(pq))
        return false;
    pnew = (Node *) malloc(sizeof(Node));
    if (pnew == NULL)
    {
        fprintf(stderr, "Unable to allocate memory!\n");
        exit(1);
    }
    pnew->item = item;
    pnew->next = NULL;
    if (QueueIsEmpty(pq))
        pq->front = pnew;
    else
        pq->rear->next = pnew;
    pq->rear = pnew;
    pq->items++;
    return true;
}
说明
- 先判满,满则直接返回
false - 新节点的
next置NULL,它将成为新的末节点 - 空队列时新节点同时是首项和末项,需设置
front - 非空队列时把新节点接到
rear->next - 最后更新
rear并递增items - 内存不足属于异常,本书的实现直接终止程序
常见错误
- 空队列时只设置
rear,忘记设置front - 先更新
rear再连接next,旧尾节点指向自身
出队
示例
说明
- 空队列时返回
false,不改动队列 - 先把首项拷贝到
*pitem,再摘除节点 - 用临时指针保存待释放节点,因为
front已前移 - 删除末项后
front自然变为NULL,rear必须手工重置 - 出队只改两个指针,不移动其余项,时间为 \(O(1)\)
常见错误
- 先
free(pq->front)再取next,属于 use-after-free - 删除最后一项后只重置
front,rear仍指向已释放节点 - 用
return返回项的值,无法区分空队列
清空队列
说明
- 循环调用
DeQueue()直到队列为空,复用已有接口 - 需要一个
Item变量接收被删除的项,内容不使用 - 清空后
front,rear均为NULL,items为0 - 只通过接口函数处理队列,不直接改写内部指针
常见错误
- 只释放节点而不更新
items,计数与实际不符 - 在清空过程中直接改
front,破坏DeQueue()的约定
数组实现队列的三种方案
语法形式
示例
说明
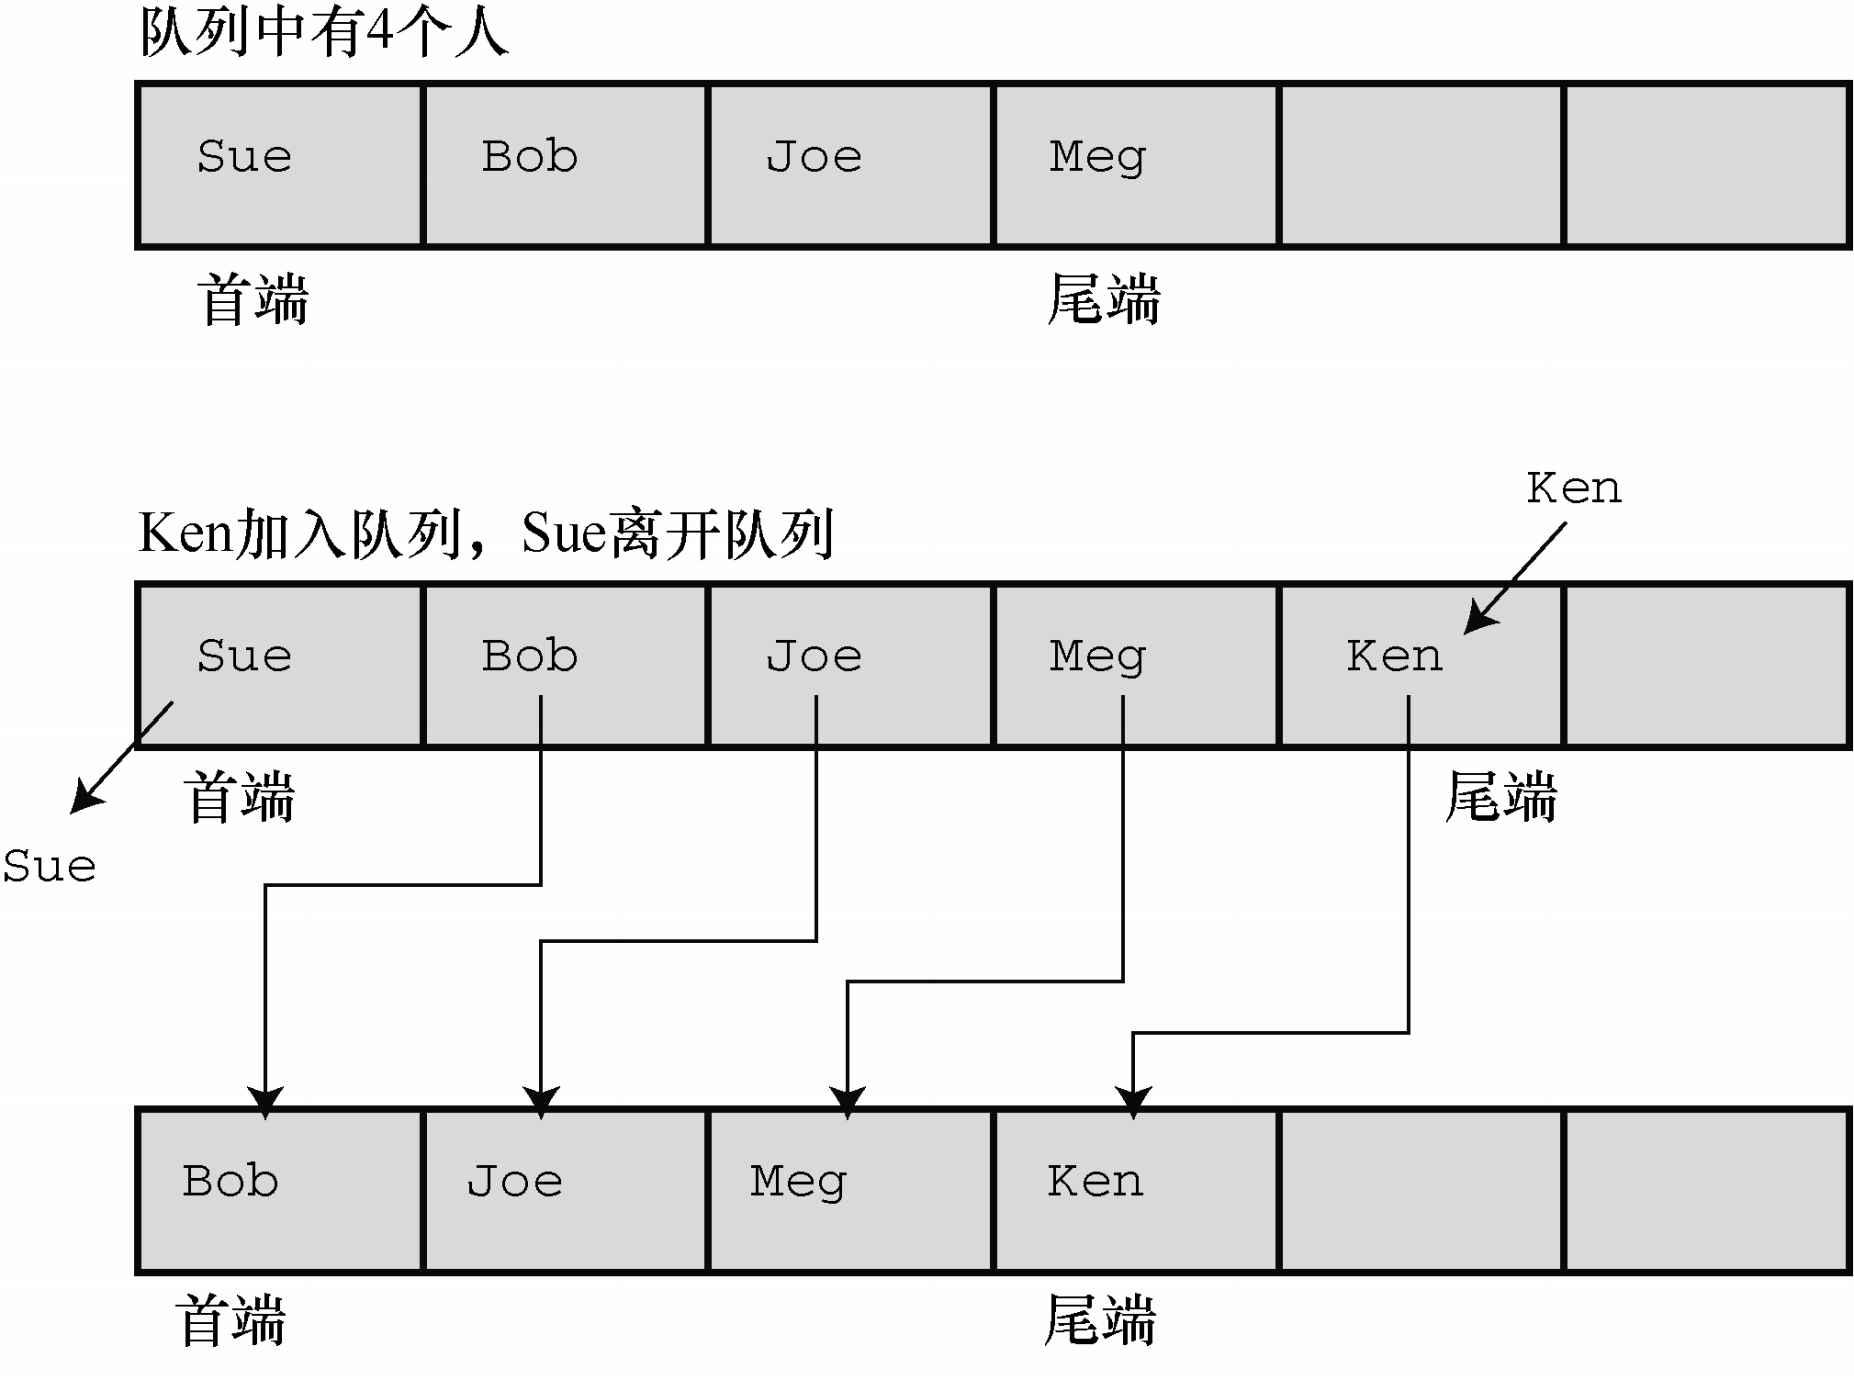
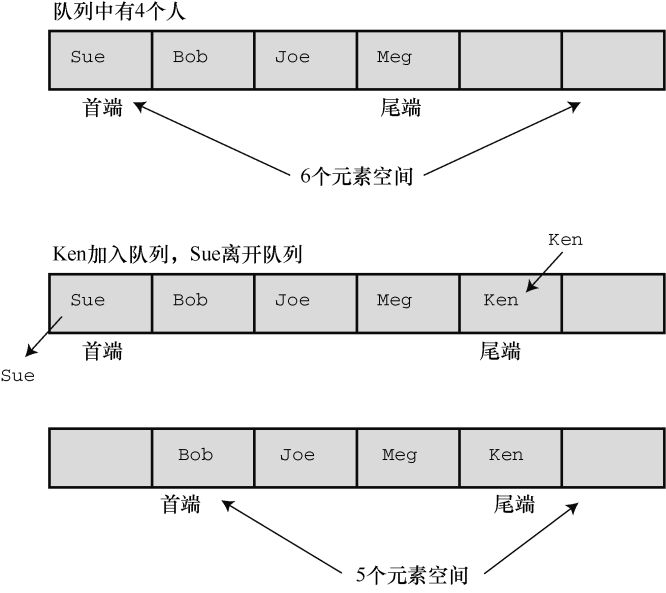
- 方案1 删除首项后把其余项依次前移,实现简单,每次删除耗时 \(O(n)\)
- 方案2 只移动首端下标,其余元素不动,但数组前端空间无法再用
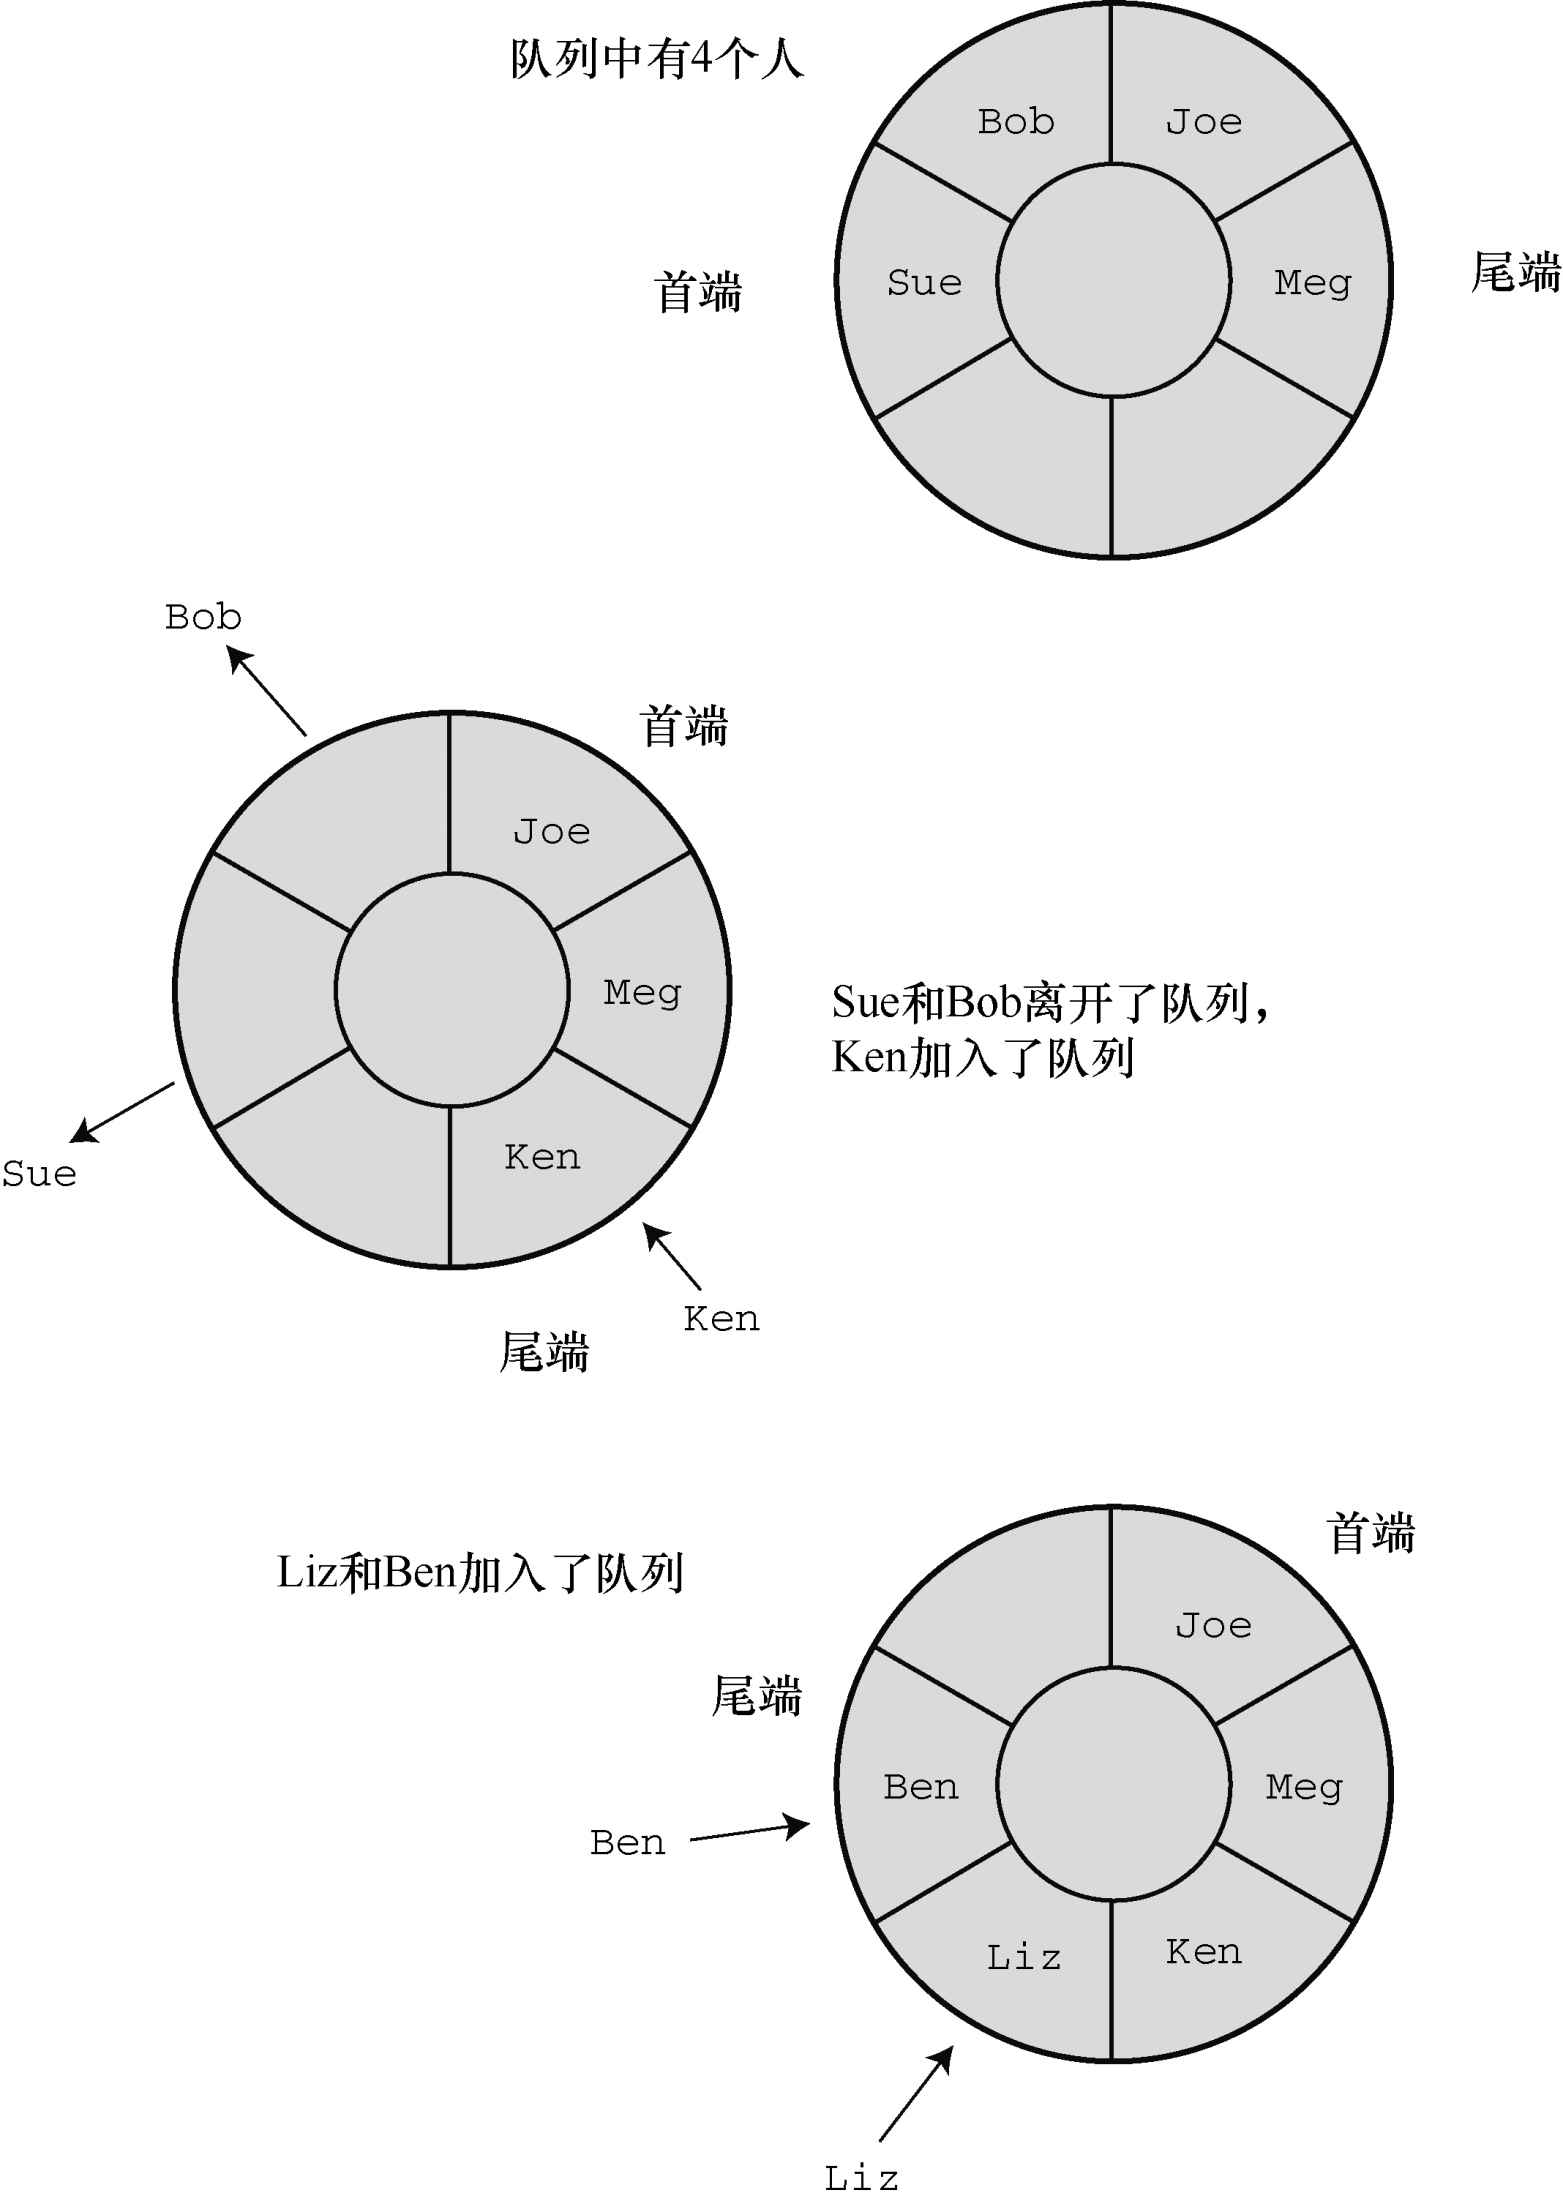
- 方案3 把数组首尾相接,下标用取模运算回绕,空间可以反复使用
- 环形队列需区分空与满,常用计数器或保留一个空位
- 这里的数组版结构与
queue.h的链表版二选一
常见错误
- 环形队列用
front == rear同时表示空和满,无法区分 - 取模时漏掉
% MAXQUEUE,下标越界
队列模拟的主循环
示例
for (cycle = 0; cycle < cyclelimit; cycle++)
{
    if (newcustomer(min_per_cust))
    {
        if (QueueIsFull(&line))
            turnaways++;
        else
        {
            customers++;
            temp = customertime(cycle);
            EnQueue(temp, &line);
        }
    }
    if (wait_time <= 0 && !QueueIsEmpty(&line))
    {
        DeQueue(&temp, &line);
        wait_time = temp.processtime;
        line_wait += cycle - temp.arrive;
        served++;
    }
    if (wait_time > 0)
        wait_time--;
    sum_line += QueueItemCount(&line);
}
说明
- 每个循环周期代表 1 分钟,时间按整数递增
- 顾客用结构表示,成员为到达时间和咨询时长
- 队列满时新顾客被拒,
turnaways计数 - 队首顾客的等待时间为当前时刻减去到达时刻
- 平均队长为
sum_line / cyclelimit,平均等待为line_wait / served - 模拟时长越长,统计值越稳定
常见错误
- 在
wait_time未归零时出队,同时服务两位顾客 - 队列已满仍调用
EnQueue(),项被静默丢弃
数组与链表的比较
语法形式
表17-1 比较数组和链表
| 数据形式 | 优点 | 缺点 |
|---|---|---|
| 数组 | C 直接支持,可随机访问 | 大小在编译时确定,插入删除费时 |
| 链表 | 大小在运行时确定,插入删除快 | 不能随机访问,需自行提供编程支持 |
说明
- 数组按下标直接定位元素,称为随机访问
- 链表只能从首节点逐个前进,称为顺序访问
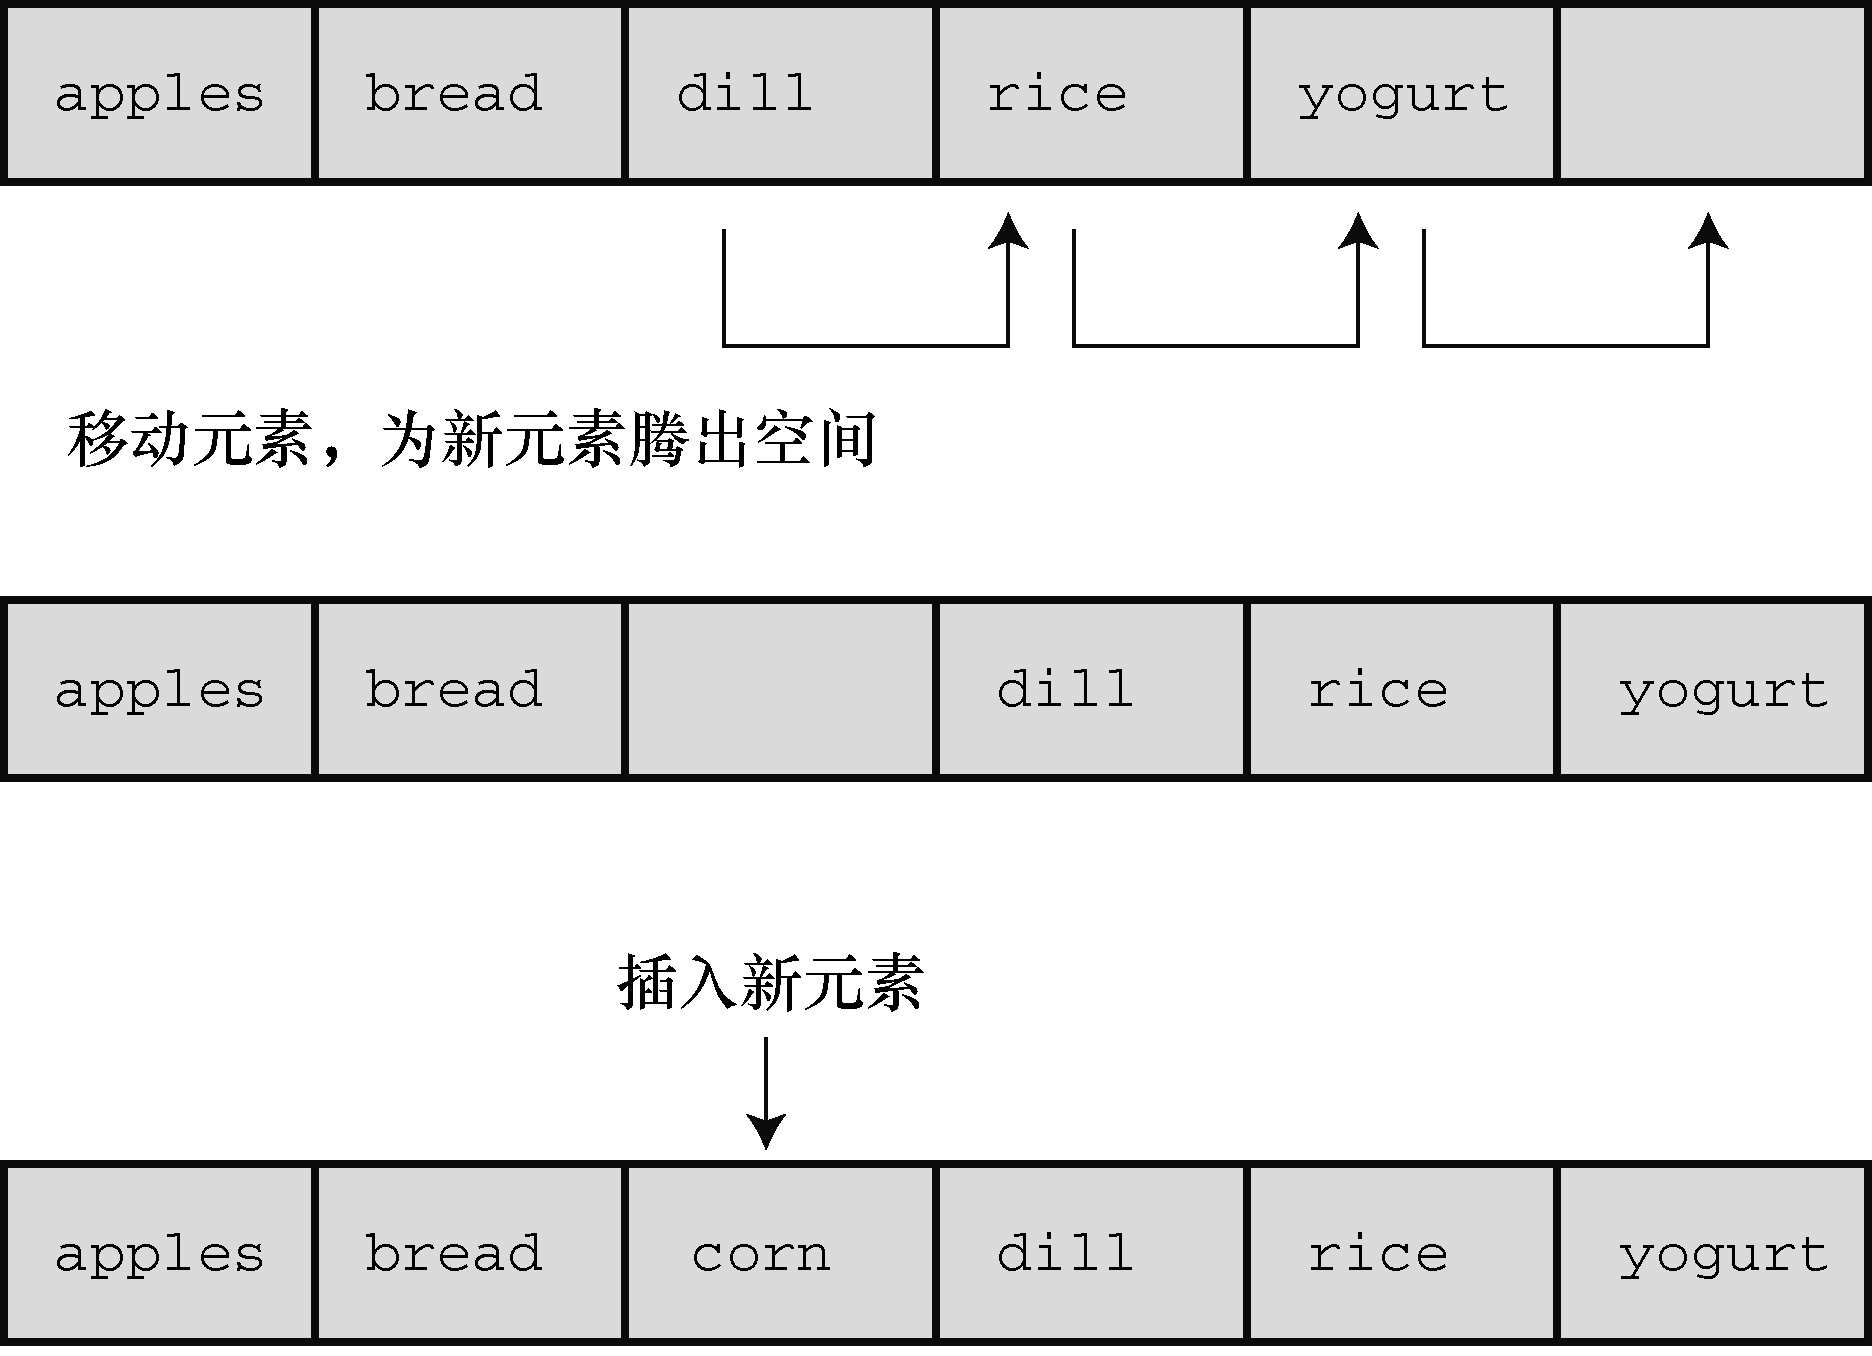
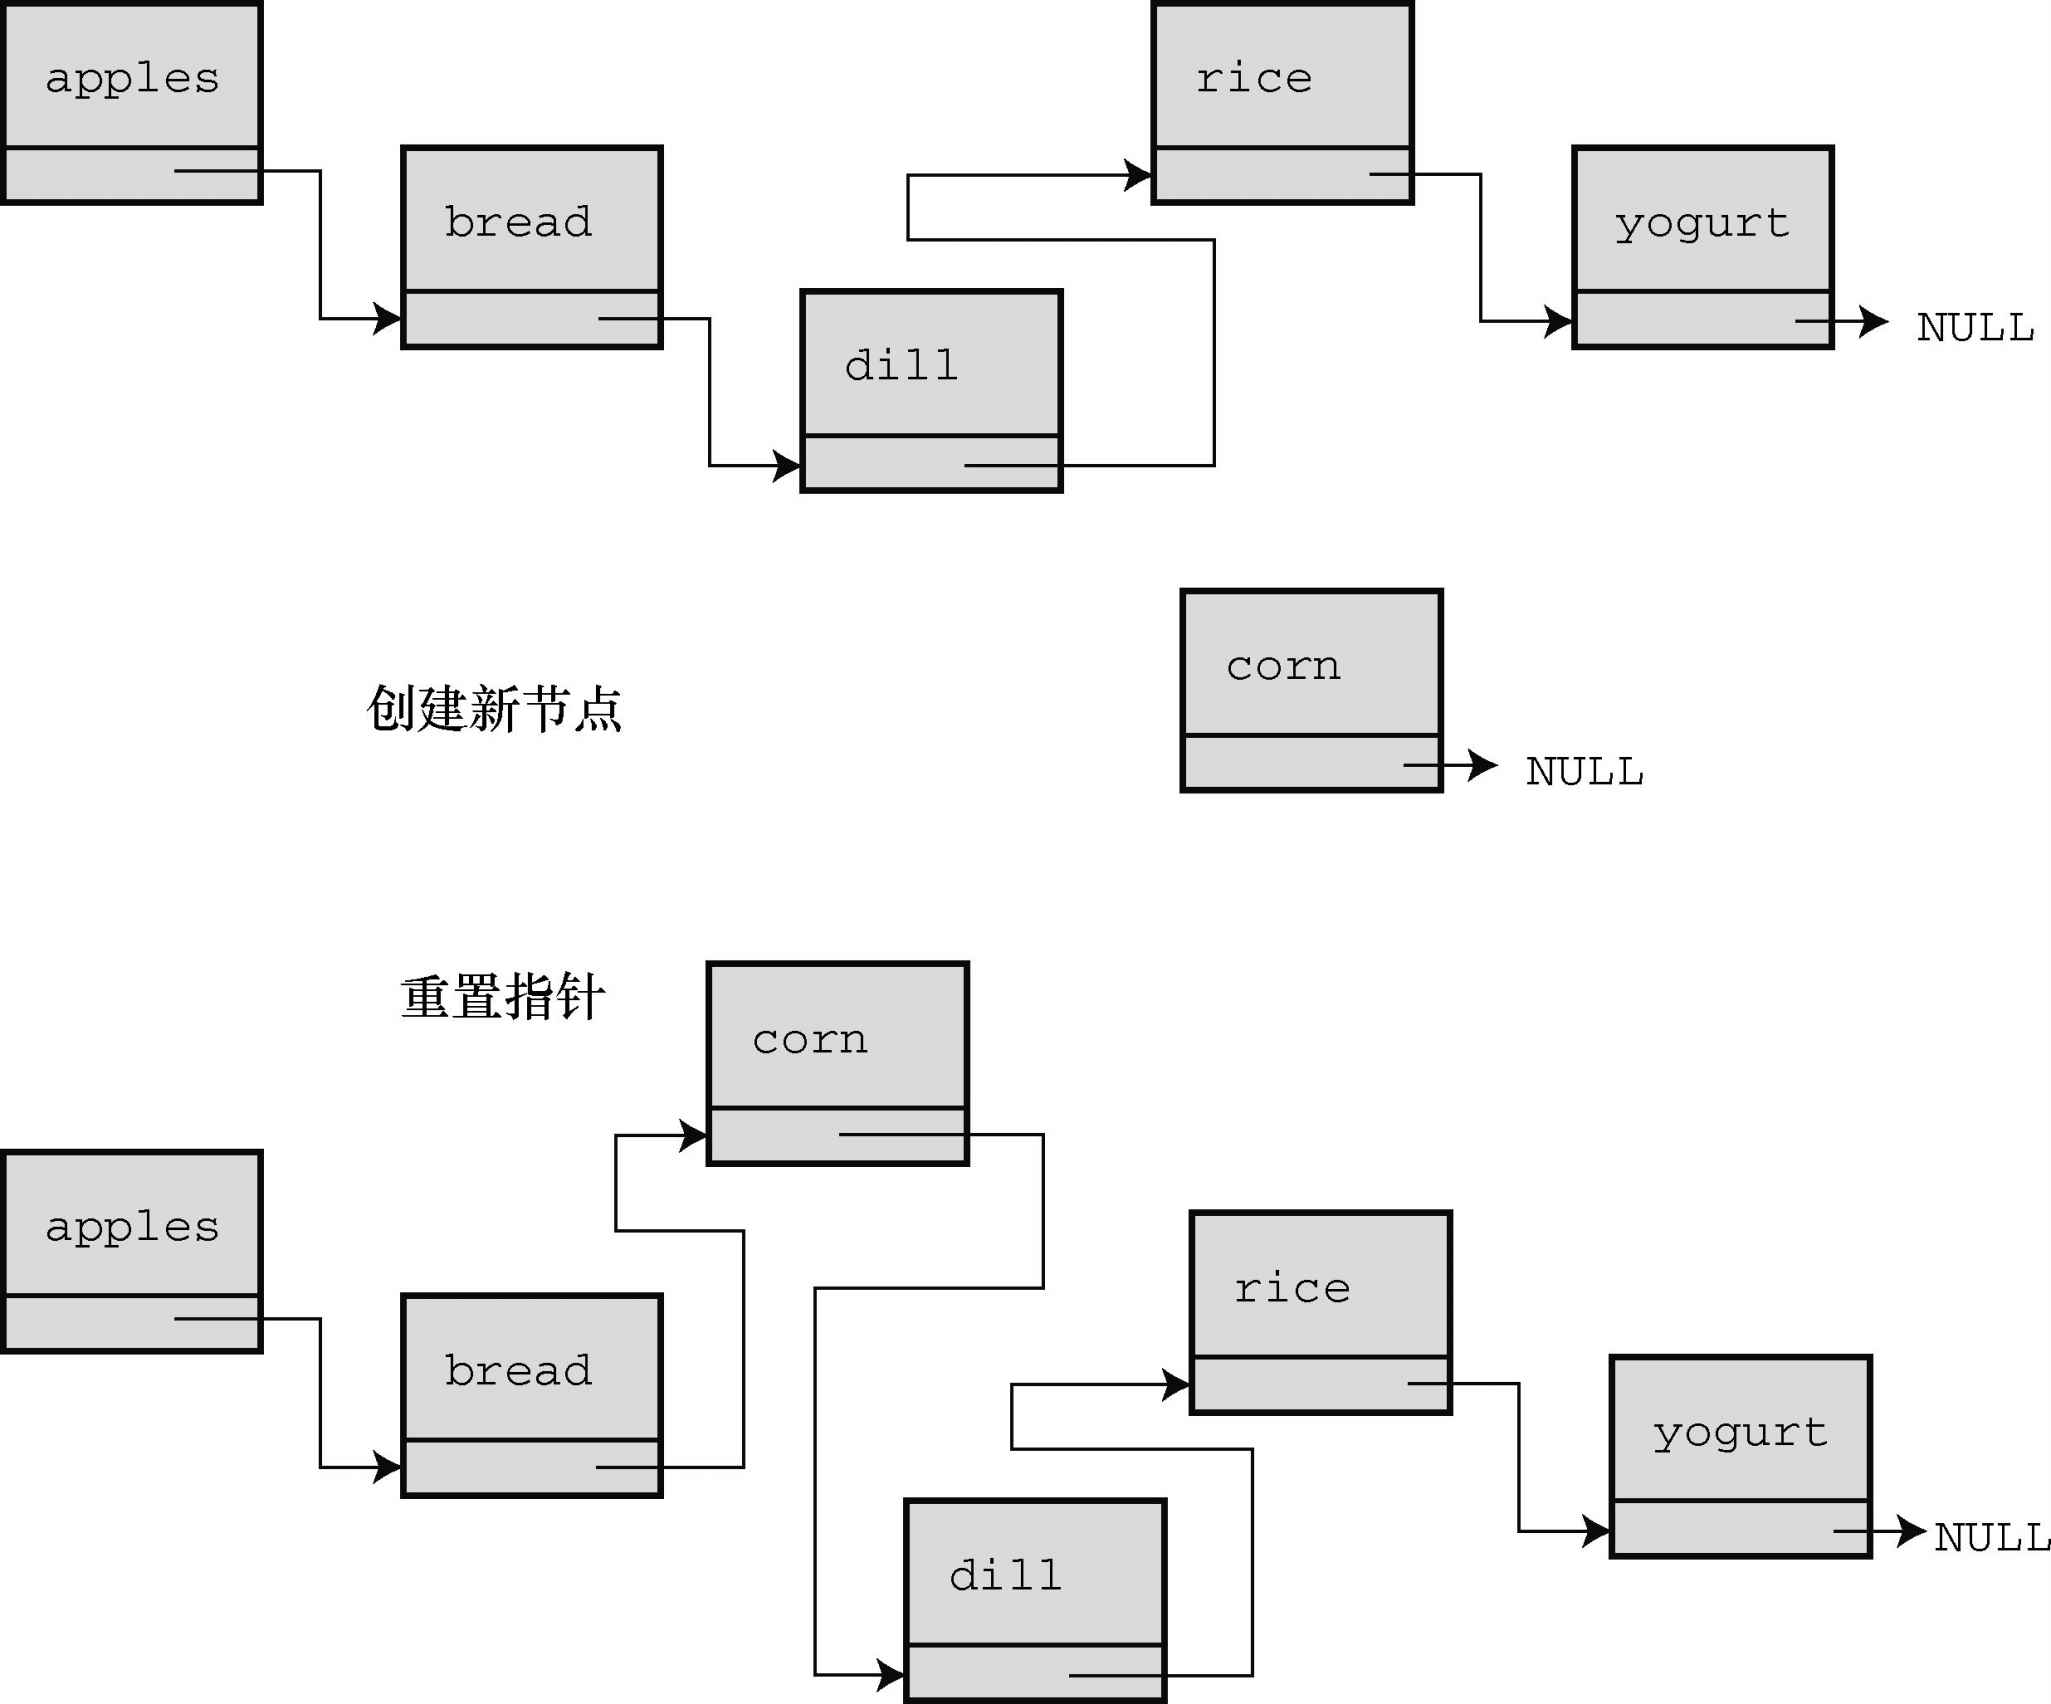
- 数组插入元素要移动其后所有元素,越靠前移动越多
- 链表插入只改两个指针,不移动已有节点
- 数组删除同样需要移动元素,链表删除只需改指针并释放节点
- 频繁插入删除且查找少时选链表,偶尔改动但查找多时选数组
常见错误
- 在链表上使用下标访问
list[i] - 认为链表插入一定比数组快,查找插入位置本身仍需 \(O(n)\)
数组上的二分查找
示例
说明
- 前提是数组已按升序排列
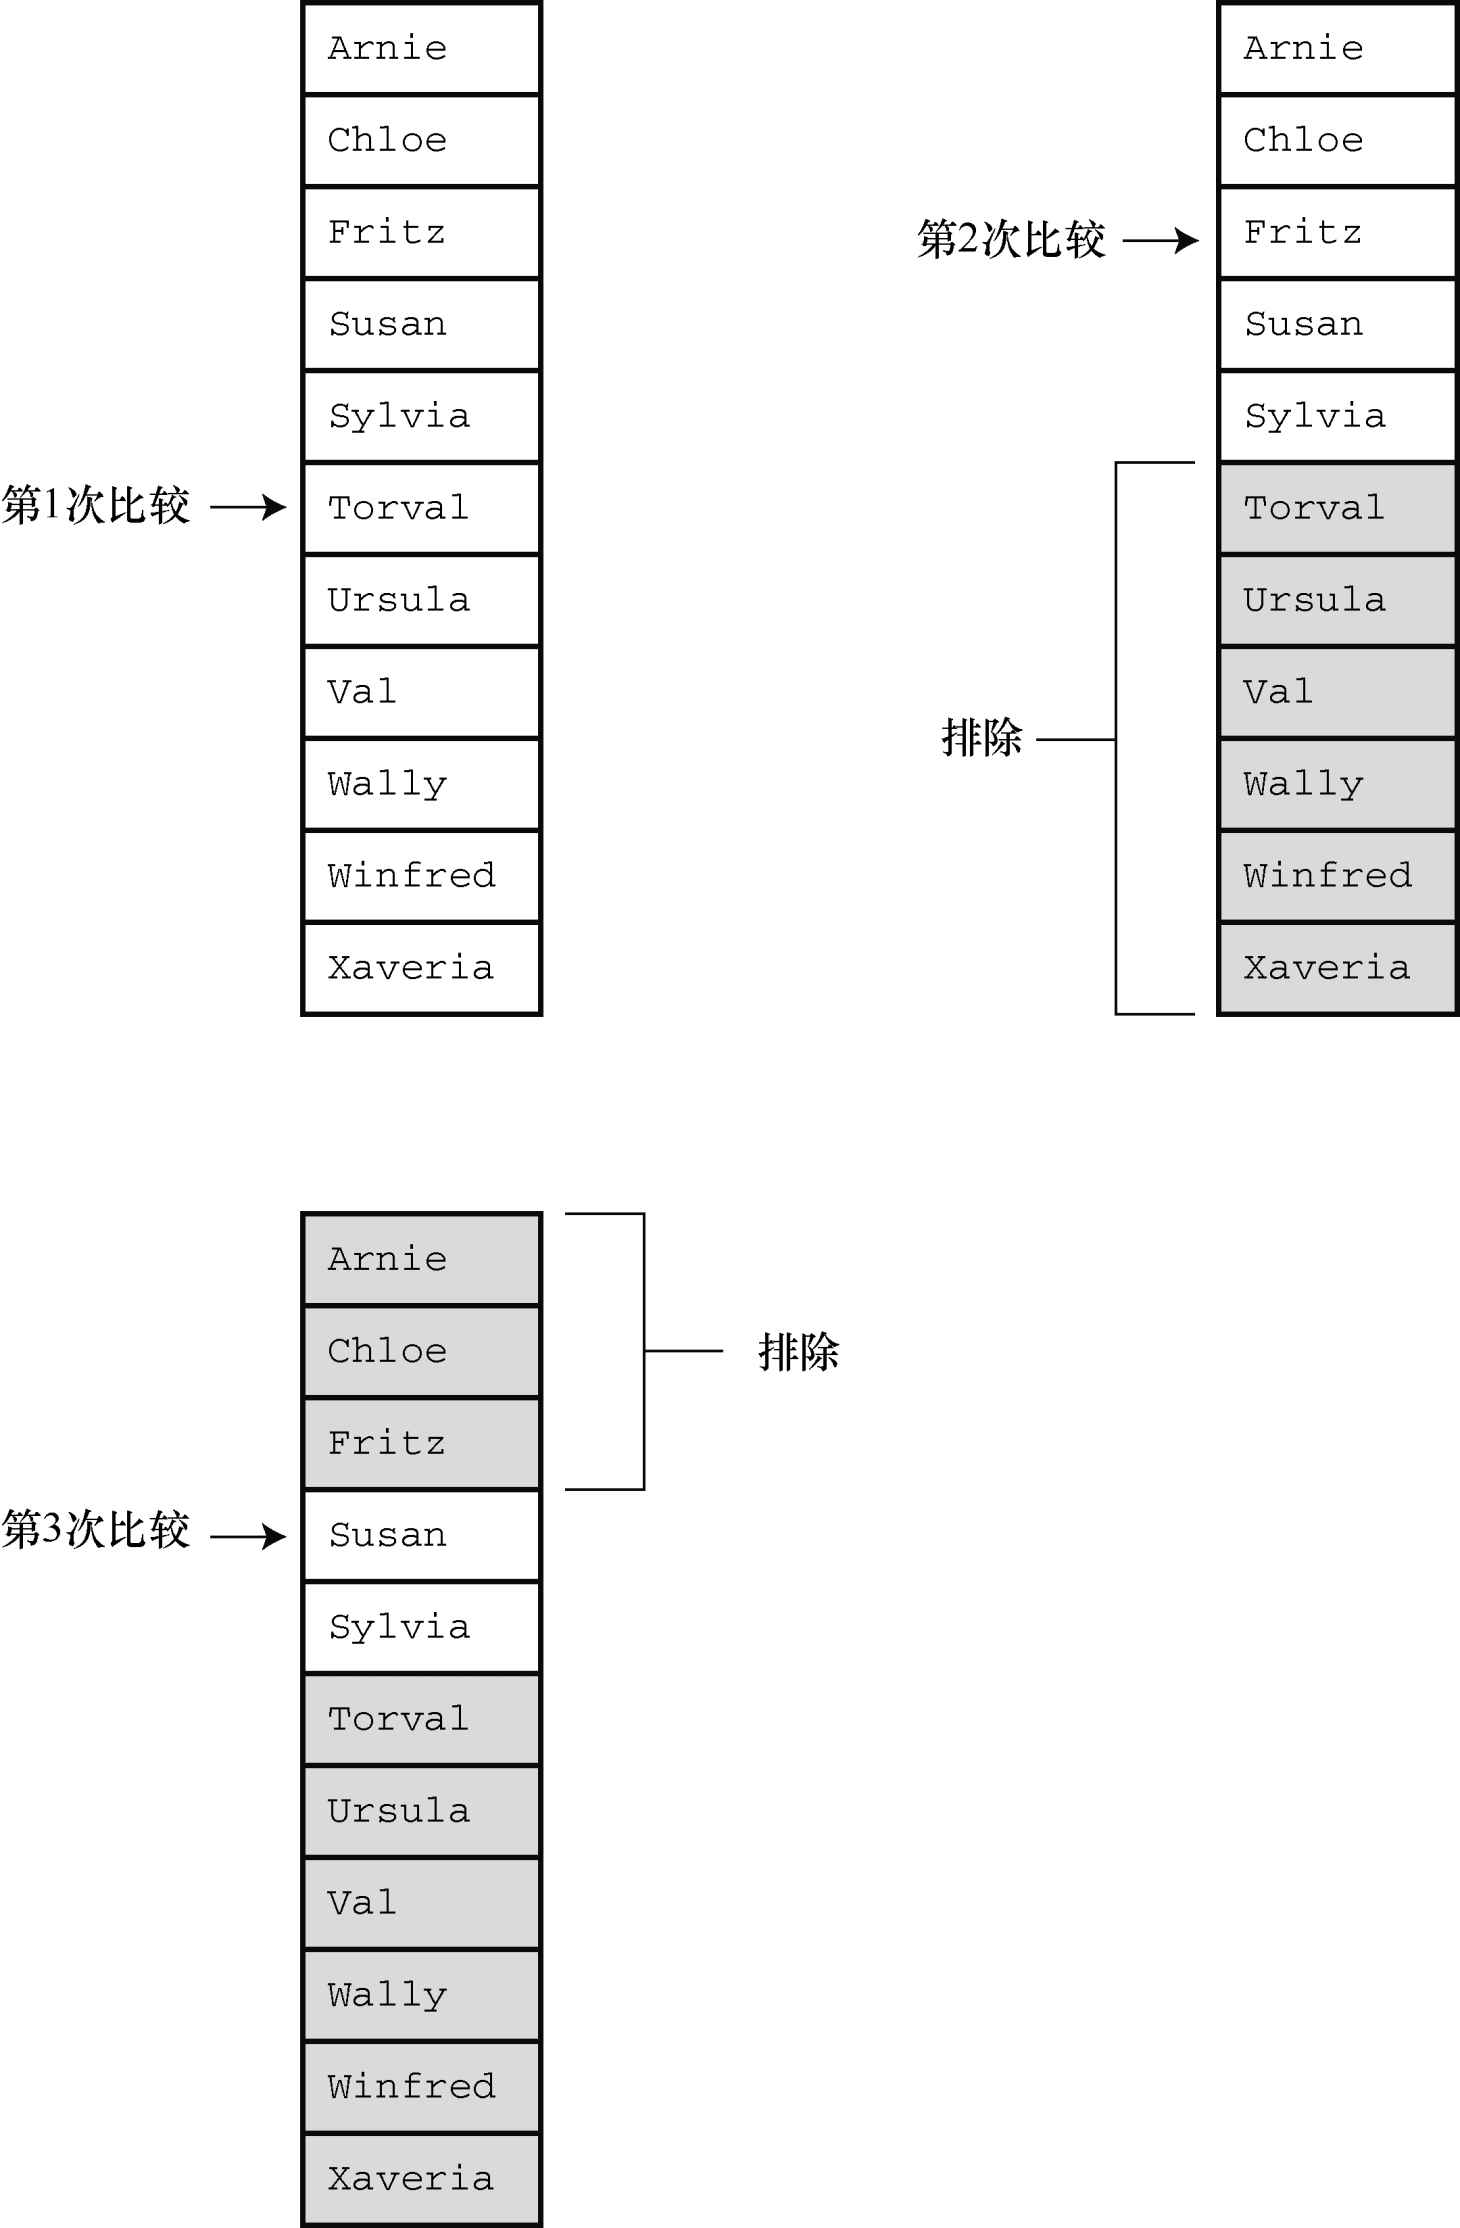
- 每次比较排除一半元素,查找范围折半
- \(n\) 次比较可处理 \(2^n-1\) 个元素,127 项最多比较 7 次
- 顺序查找平均比较 \(n/2\) 次,无序数据只能顺序查找
- 链表不支持随机访问,无法取中点,不能使用二分查找
常见错误
- 在未排序的数组上使用二分查找
- 循环条件写成
low < high,漏掉最后一个元素 - 更新边界写成
low = mid,区间不缩小,死循环
二叉查找树的节点与树类型
语法形式
说明
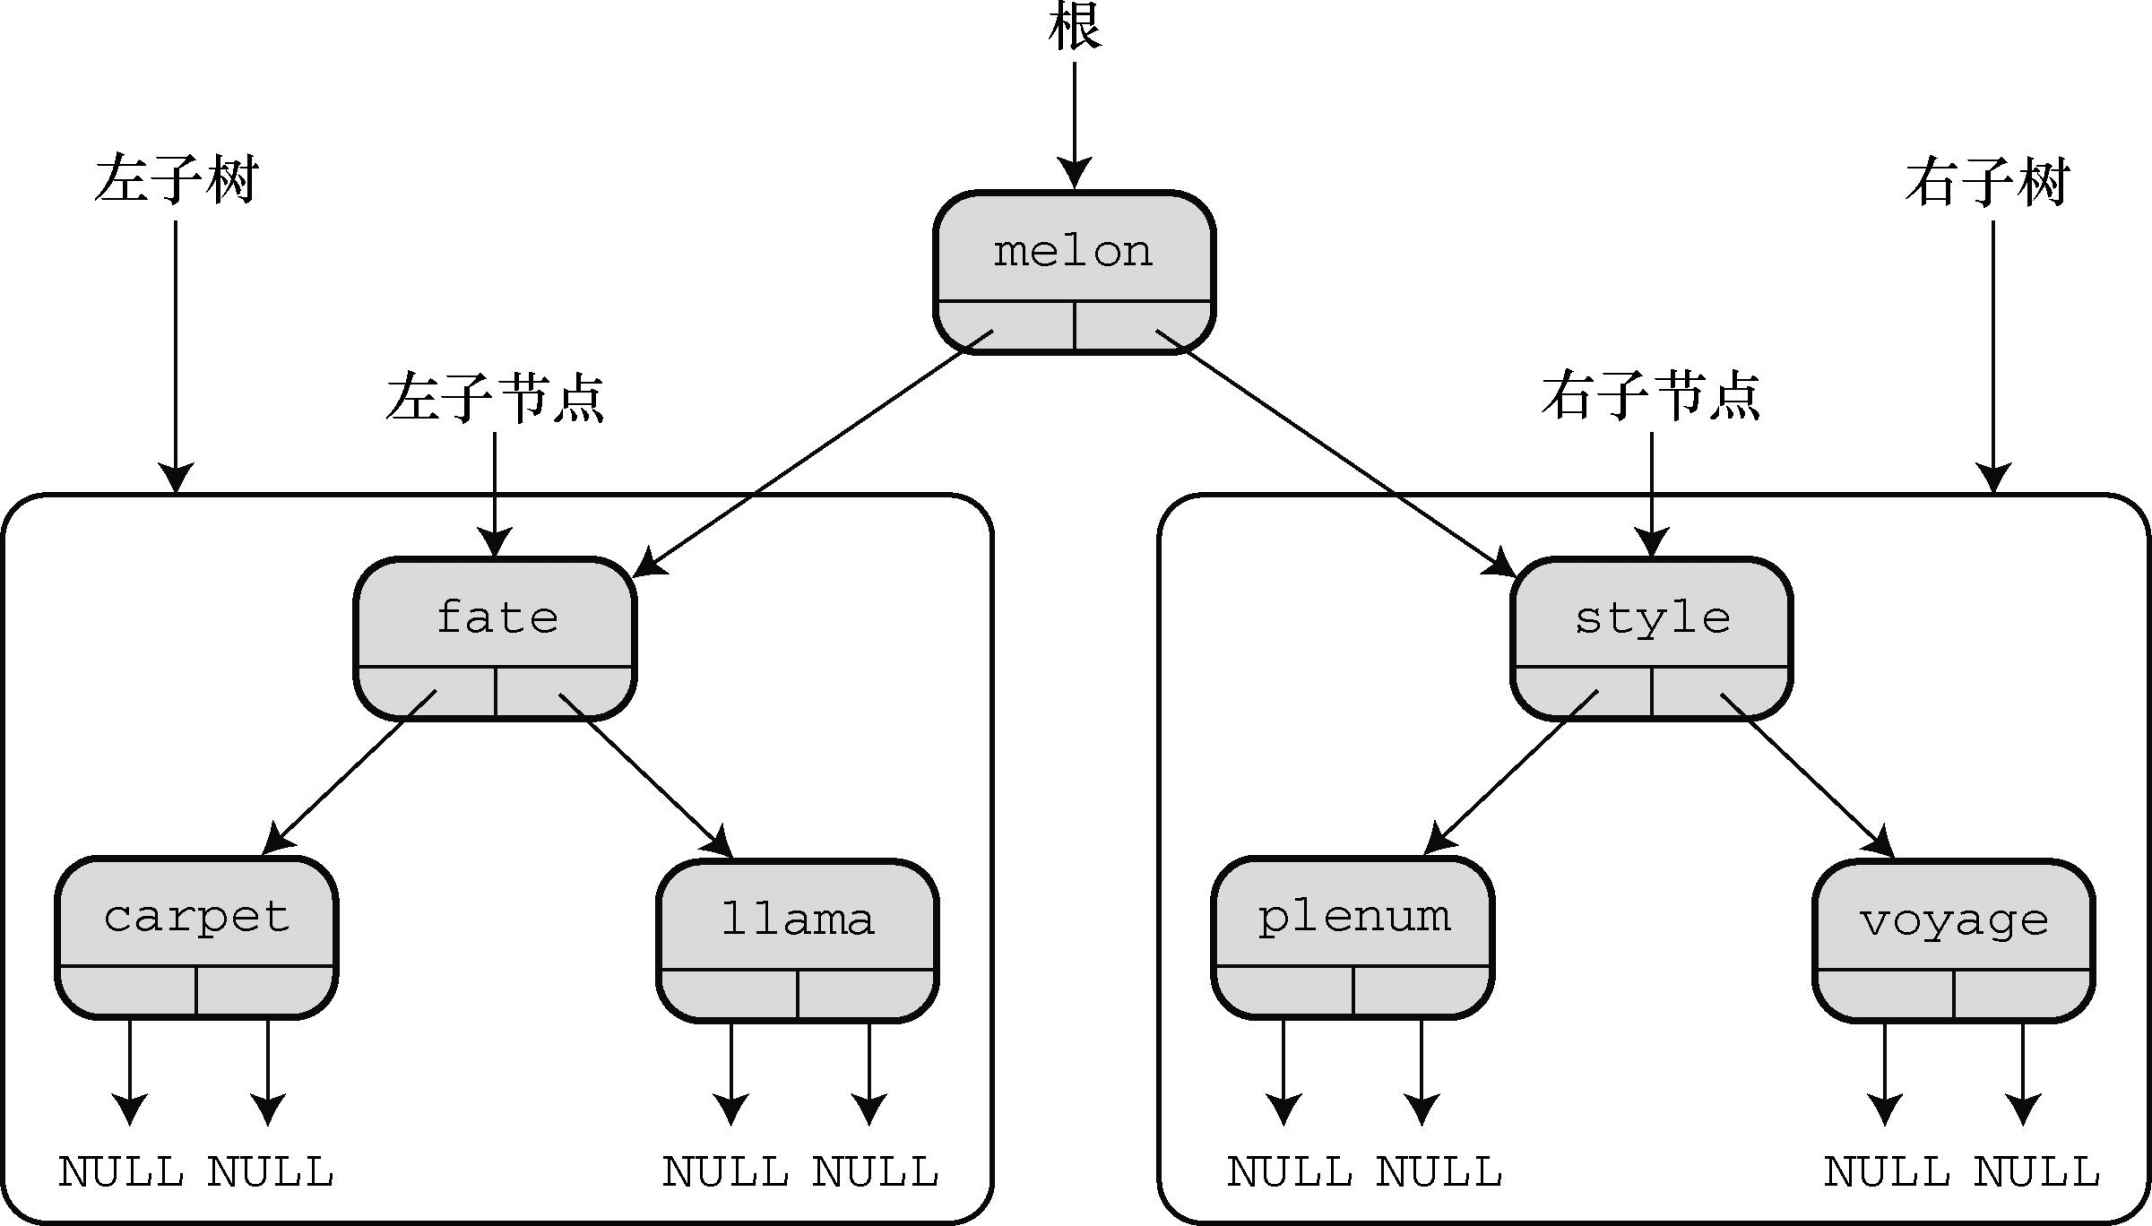
- 每个节点包含一个项和两个指针,分别指向左子节点和右子节点
- 左子树的所有项排在根项之前,右子树的所有项排在根项之后
- 该关系对每个节点成立,所以整棵树按项的大小分层排列
- 树要么是空树,要么是一个根节点及其两棵子树
- 本书的二叉查找树不允许重复项
root为NULL表示空树,size记录项数- 也可以用指向节点的指针表示树,用结构便于同时记录项数
常见错误
- 把节点类型写成与
tree.h不一致的名称,多文件编译时类型冲突 - 认为左右子树的高度相近,树的效率取决于是否平衡
[17.7.2 节的节点类型写作 Trn,与 tree.h 的 Trnode 不一致,按后文统一]
二叉查找树的接口
语法形式
void InitializeTree(Tree * ptree);
bool TreeIsEmpty(const Tree * ptree);
bool TreeIsFull(const Tree * ptree);
int TreeItemCount(const Tree * ptree);
bool AddItem(const Item * pi, Tree * ptree);
bool InTree(const Item * pi, const Tree * ptree);
bool DeleteItem(const Item * pi, Tree * ptree);
void Traverse(const Tree * ptree,
              void (*pfun)(Item item));
void DeleteAll(Tree * ptree);
示例
说明
- 查找与删除按项的地址传参,避免复制整个
Item - 不修改树的函数加
const AddItem()同时检查树满和重复项Traverse()用函数指针处理每一项,与链表版接口一致DeleteAll()释放全部节点并把树重置为空
常见错误
AddItem()按值传Item,大型结构复制开销大- 删除项时按值传参,与查找函数的参数形式不一致
树的初始化与状态查询
示例
说明
- 空树的条件是根指针为
NULL - 上限由
MAXITEMS决定,本书取 10 便于测试树满的情况 - 项数直接返回
size,不需要遍历 - 节点的增删必须同步维护
size
常见错误
- 只把
size置 0,未把root置NULL - 删除节点后忘记递减
size,判满提前触发
树中插入项
示例
static Trnode * MakeNode(const Item * pi)
{
    Trnode * new_node;

    new_node = (Trnode *) malloc(sizeof(Trnode));
    if (new_node != NULL)
    {
        new_node->item = *pi;
        new_node->left = NULL;
        new_node->right = NULL;
    }
    return new_node;
}

bool AddItem(const Item * pi, Tree * ptree)
{
    Trnode * new_node;

    if (TreeIsFull(ptree))
        return false;
    if (SeekItem(pi, ptree).child != NULL)
        return false;            /* 已存在相同的项 */
    new_node = MakeNode(pi);
    if (new_node == NULL)
        return false;
    ptree->size++;
    if (ptree->root == NULL)
        ptree->root = new_node;
    else
        AddNode(new_node, ptree->root);
    return true;
}
说明
- 插入前先判满,再判重,任一失败都返回
false MakeNode()分配并初始化节点,左右指针置NULLsize在节点挂入树之前递增,保证计数与插入一致- 空树时新节点直接成为根
- 非空树交给
AddNode()递归定位 MakeNode(),AddNode(),SeekItem()是static辅助函数- 这些辅助函数只在本文件可见,不属于公共接口
常见错误
- 不检查重复项,树中出现相同项,查找和删除行为不确定
- 在
malloc()失败后继续访问新节点
按子树递归插入
语法形式
示例
static void AddNode(Trnode * new_node, Trnode * root)
{
    if (ToLeft(&new_node->item, &root->item))
    {
        if (root->left == NULL)
            root->left = new_node;
        else
            AddNode(new_node, root->left);
    }
    else if (ToRight(&new_node->item, &root->item))
    {
        if (root->right == NULL)
            root->right = new_node;
        else
            AddNode(new_node, root->right);
    }
    else
    {
        fprintf(stderr, "location error in AddNode()\n");
        exit(1);
    }
}
说明
- 每层递归把当前子树根节点作为
root - 新项较小则进入左子树,较大则进入右子树
- 遇到空子树时挂入新节点,递归结束
- 两个比较都不成立说明项相等,与不允许重复的约定矛盾,按内部错误处理
- 递归深度等于插入路径长度,平衡树为 \(O(\log n)\)
常见错误
- 递归调用时传入
root而非root->left或root->right - 把相等情况当作正常分支,允许了重复项
比较函数 ToLeft 与 ToRight
语法形式
示例
static bool ToLeft(const Item * i1, const Item * i2)
{
    int comp1;

    if ((comp1 = strcmp(i1->petname,
                        i2->petname)) < 0)
        return true;
    else if (comp1 == 0 &&
             strcmp(i1->petkind, i2->petkind) < 0)
        return true;
    else
        return false;
}

static bool ToRight(const Item * i1, const Item * i2)
{
    int comp1;

    if ((comp1 = strcmp(i1->petname,
                        i2->petname)) > 0)
        return true;
    else if (comp1 == 0 &&
             strcmp(i1->petkind, i2->petkind) > 0)
        return true;
    else
        return false;
}
说明
- 两项都是结构,不能用
<和>直接比较 - 先按名称比较,名称相同再按种类比较
- 两个函数把比较规则集中在一处,
AddNode()与SeekItem()不必关心项的内部结构 - 换用其他数据形式时只改这两个函数
strcmp()返回负数,0,正数,分别表示前串在后串之前,相同,之后
常见错误
- 只比较名称,同名不同种类的项被判为重复
- 在
ToRight()中沿用< 0的判断,左右子树颠倒
查找项与父节点
语法形式
示例
static Pair SeekItem(const Item * pi,
                     const Tree * ptree)
{
    Pair look;
    look.parent = NULL;
    look.child = ptree->root;
    while (look.child != NULL)
    {
        if (ToLeft(pi, &look.child->item))
        {
            look.parent = look.child;
            look.child = look.child->left;
        }
        else if (ToRight(pi, &look.child->item))
        {
            look.parent = look.child;
            look.child = look.child->right;
        }
        else
            break;
    }
    return look;
}

bool InTree(const Item * pi, const Tree * ptree)
{
    return SeekItem(pi, ptree).child != NULL;
}
说明
child指向找到的节点,未找到时为NULLparent指向该节点的父节点,根节点时为NULL- 删除操作需要父节点,以便更新指向子节点的指针
- 用
while循环从上到下查找,也可以写成递归 - 找到时
break,因为两个比较都不成立即表示相等 InTree()只关心child是否为空
常见错误
- 更新
child时忘记同步更新parent - 把比较结果相等的情况漏掉,循环继续进入错误分支
删除节点
示例
static void DeleteNode(Trnode ** ptr)
{
    Trnode * temp;

    if ((*ptr)->left == NULL)
    {
        temp = *ptr;
        *ptr = (*ptr)->right;
        free(temp);
    }
    else if ((*ptr)->right == NULL)
    {
        temp = *ptr;
        *ptr = (*ptr)->left;
        free(temp);
    }
    else
    {
        for (temp = (*ptr)->left;
             temp->right != NULL;
             temp = temp->right)
            continue;
        temp->right = (*ptr)->right;
        temp = *ptr;
        *ptr = (*ptr)->left;
        free(temp);
    }
}
说明
- 参数取
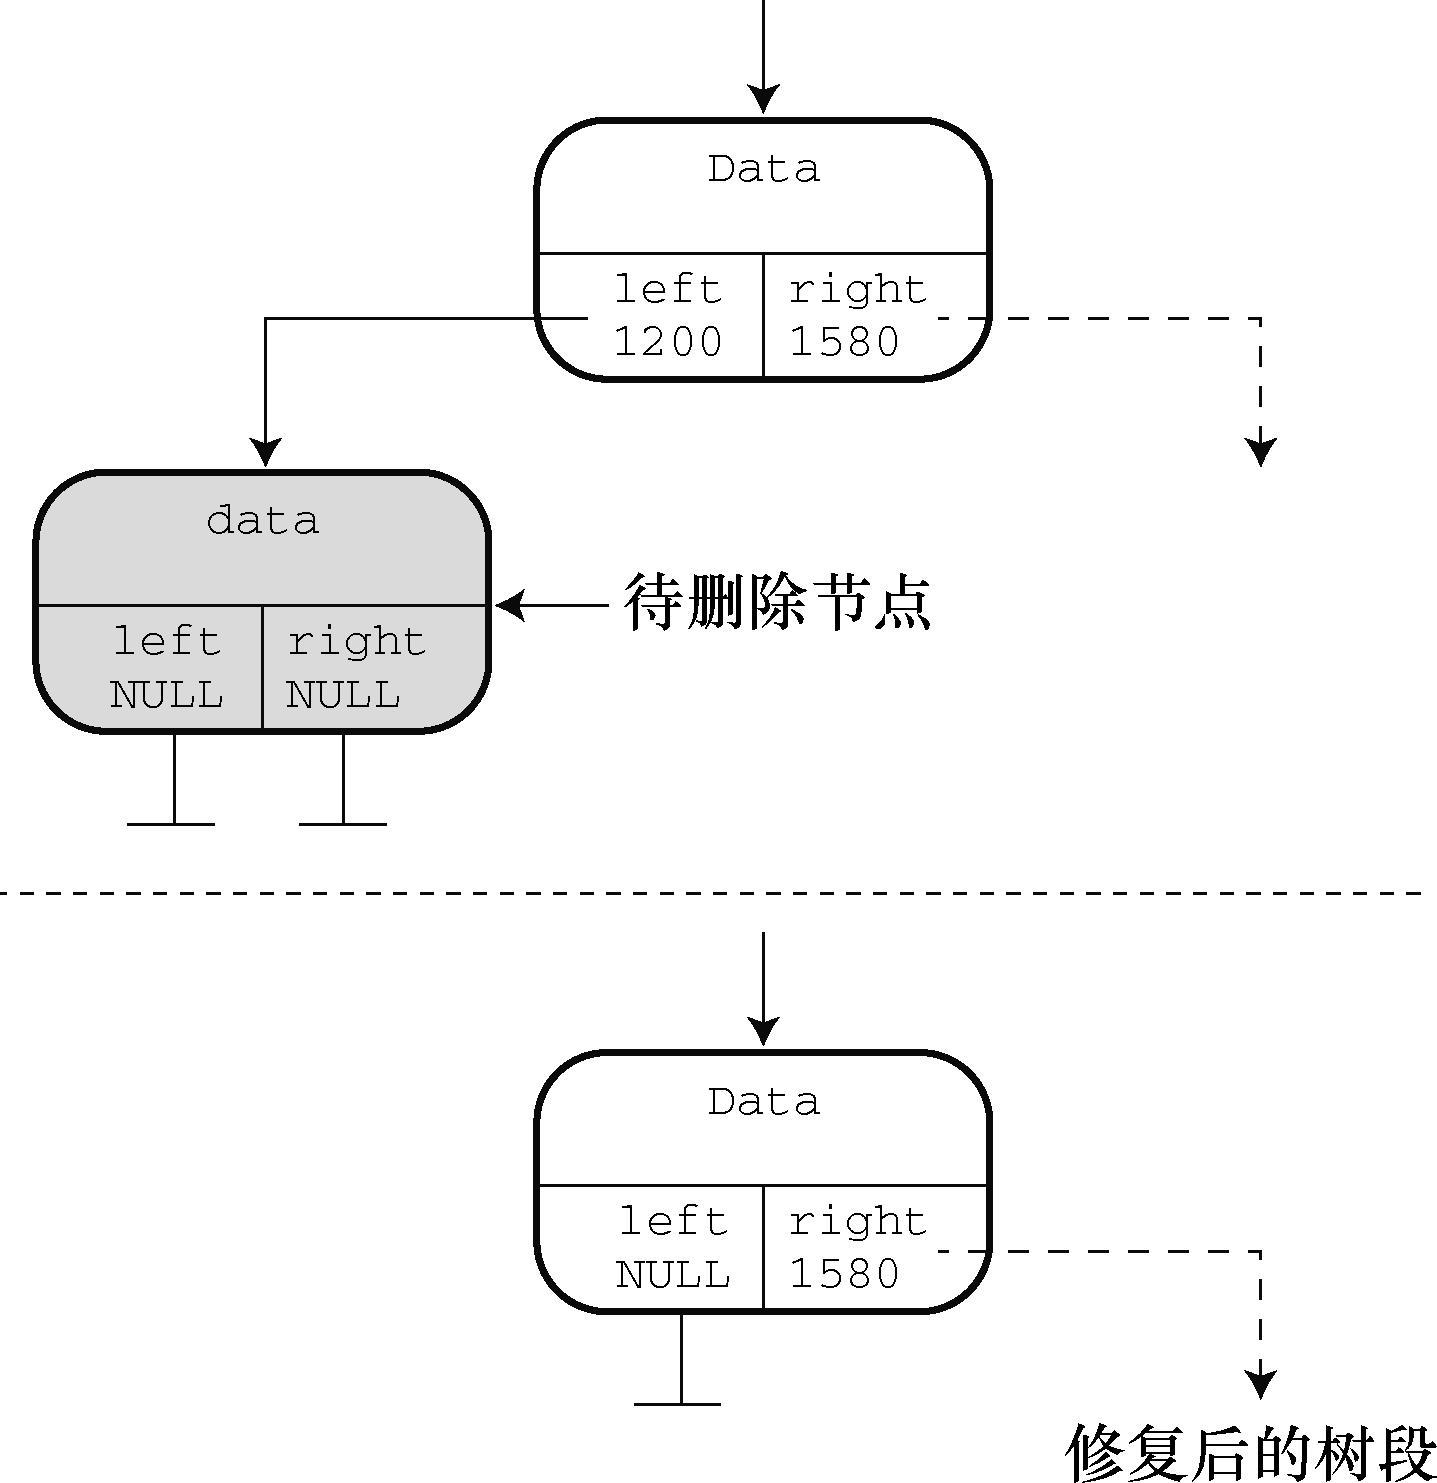
Trnode **,因为要改写父节点中保存的指针 - 无左子节点时用右子节点顶替,无右子节点时用左子节点顶替
- 叶节点属于第一种情况,右子节点为
NULL,顶替结果为空 - 有两个子节点时,先沿左子树的右支找到最大节点
- 把右子树接到该最大节点的右边,再用左子树顶替被删节点
- 这种策略保留了二叉查找树的大小关系,不需要复制项
- 先保存节点地址再改写指针,最后
free()
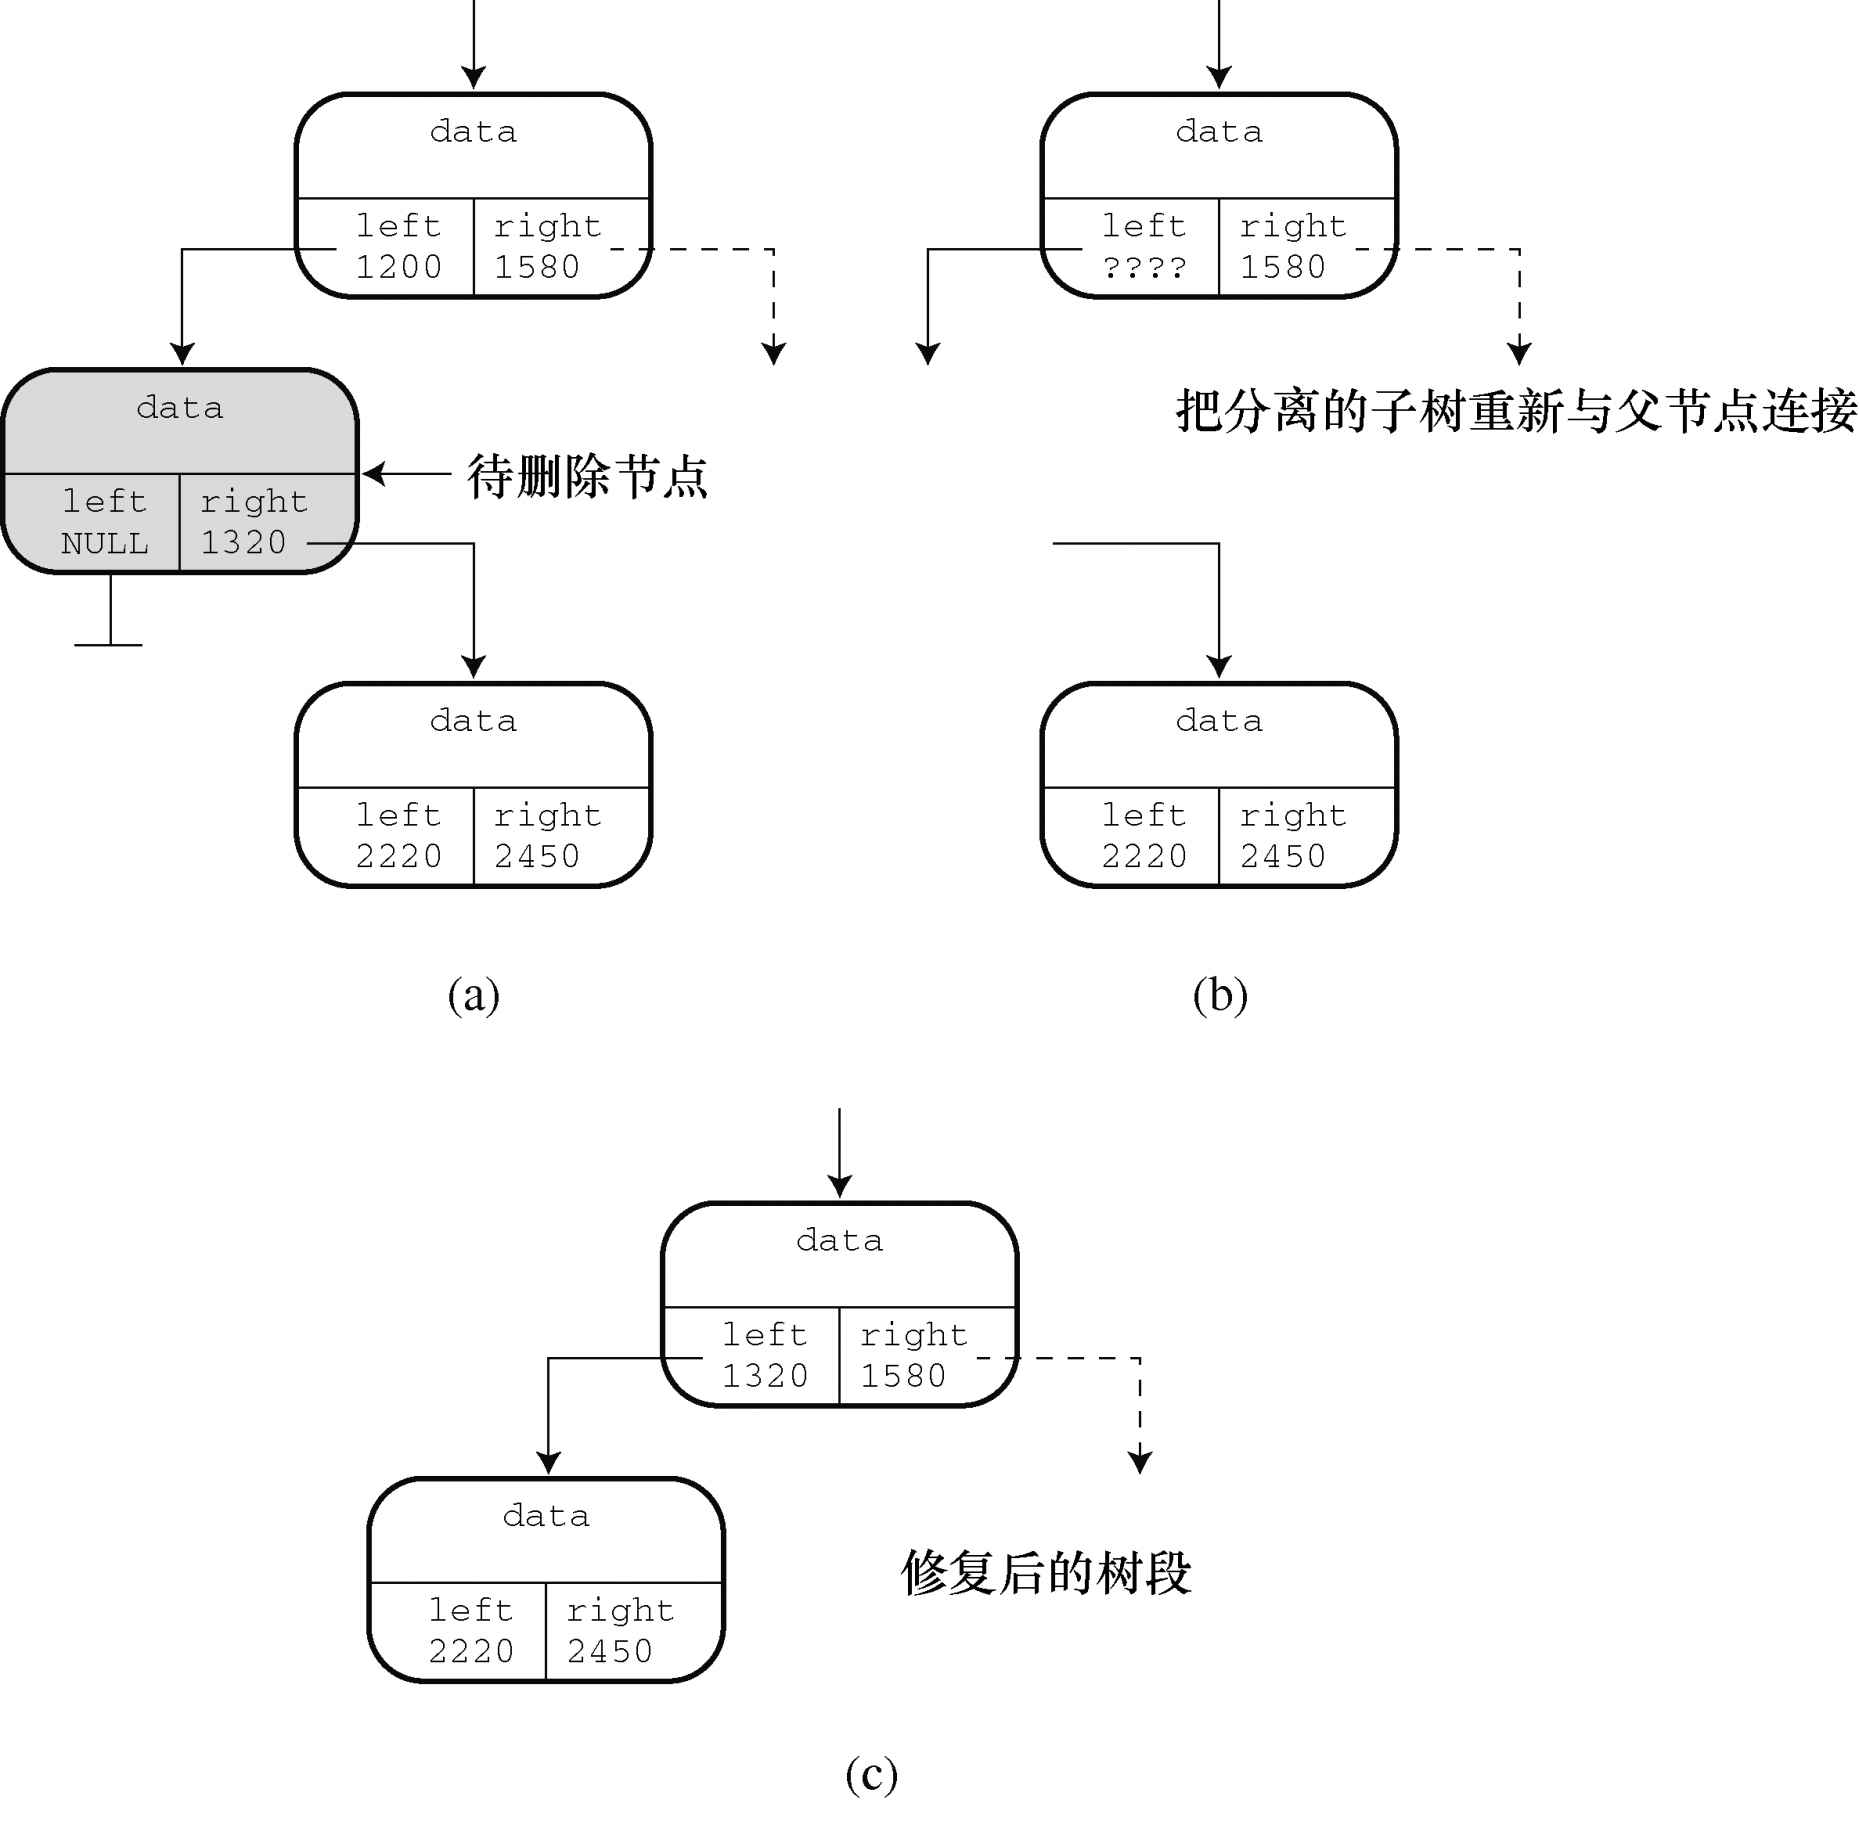
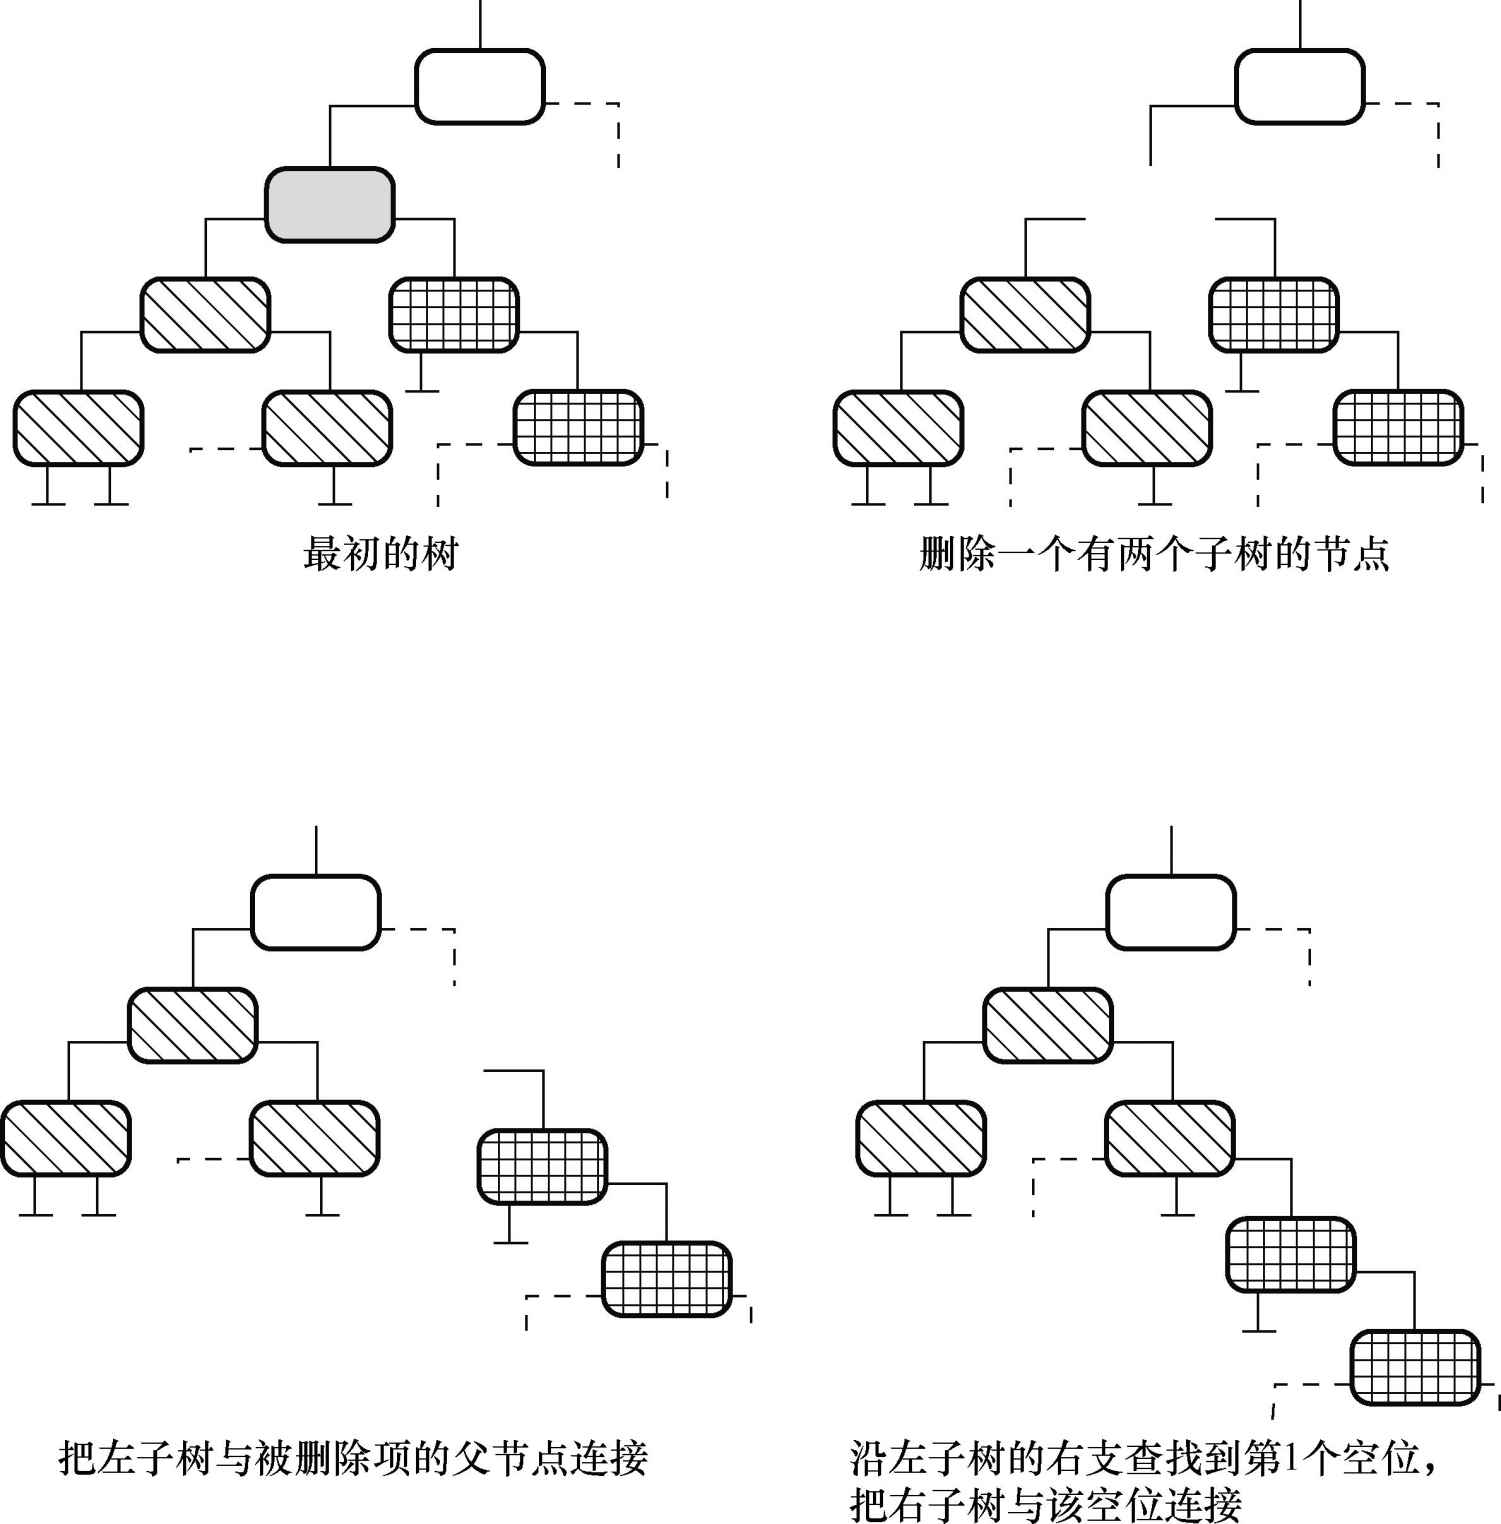
常见错误
- 参数写成
Trnode *,只改局部指针,树中仍指向已释放节点 - 先
free()再取子节点地址,属于 use-after-free - 两个子节点时把右子树挂到左子树的左边,破坏大小关系
删除指定项
示例
bool DeleteItem(const Item * pi, Tree * ptree)
{
    Pair look;

    look = SeekItem(pi, ptree);
    if (look.child == NULL)
        return false;
    if (look.parent == NULL)
        DeleteNode(&ptree->root);
    else if (look.parent->left == look.child)
        DeleteNode(&look.parent->left);
    else
        DeleteNode(&look.parent->right);
    ptree->size--;
    return true;
}
说明
SeekItem()同时给出目标节点和父节点- 目标为根节点时传入根指针的地址
- 否则判断目标是父节点的左子节点还是右子节点,传入对应成员的地址
- 删除成功后递减
size - 未找到时返回
false,树不变 - 接口函数只处理项与树,指针细节由
DeleteNode()完成
常见错误
- 用
look.child的地址传给DeleteNode(),改的是副本 - 删除根节点与其他节点走同一分支,根指针没有更新
中序遍历
示例
说明
- 中序顺序为左子树,根项,右子树
- 二叉查找树的中序遍历结果按项从小到大排列
- 前序为项,左,右; 后序为左,右,项
- 递归到空子树时返回,是递归的终止条件
- 遍历本身不改变树,只把每项交给
pfun处理一次
常见错误
- 先处理根项再处理左子树,输出不再有序
- 忘记判断
root != NULL,对空树解引用
清空树
示例
说明
- 遍历每个节点并释放,最后把树重置为空
- 释放当前节点前保存
right,因为释放后不能再读该成员 - 先递归左子树,再释放根,再递归右子树
DeleteAll()负责重置Tree结构,DeleteAllNodes()只负责释放节点- 清空后
root为NULL,size为0
常见错误
- 先
free(root)再取root->right,属于 use-after-free - 只释放节点不重置
root和size,树变成悬空状态
不平衡的二叉查找树
示例
说明
- 二叉查找树的效率取决于树的形状,平衡时查找为 \(O(\log n)\)
- 按有序顺序插入时,每个新节点都落在右侧,树退化为单支
- 这种树的查找退化为顺序查找,与链表相同
- 删除操作也可能使原本平衡的树变得不平衡
- AVL 树在插入和删除后重新平衡,保证查找效率
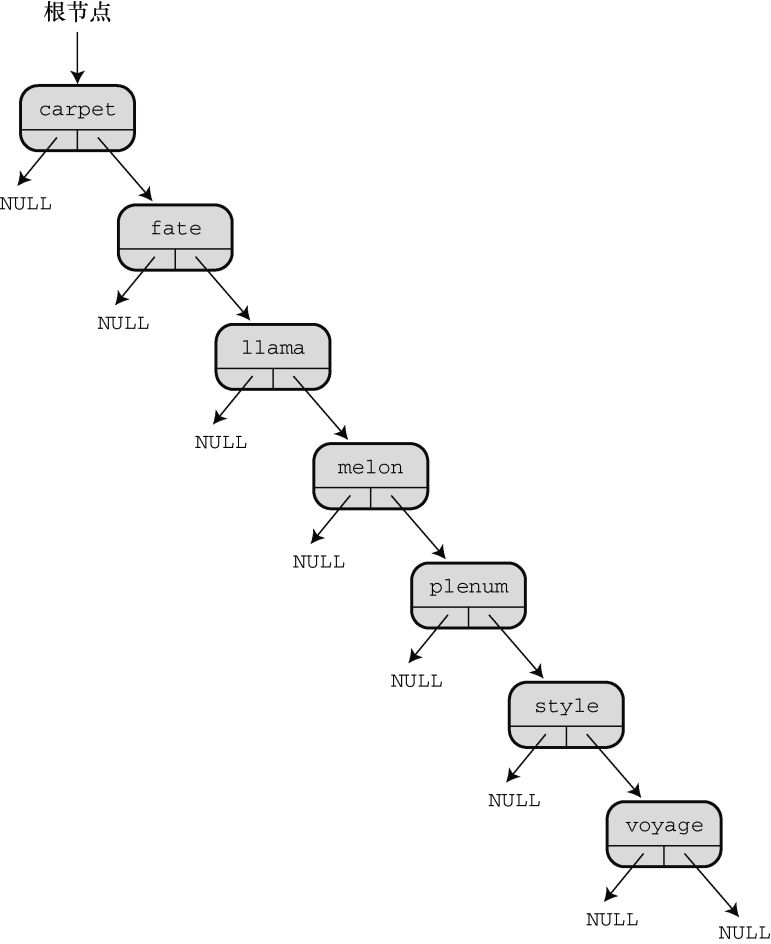
常见错误
- 认为二叉查找树的查找一定是 \(O(\log n)\)
- 用有序数据建树后仍按平衡树的复杂度估算
复习题
(1)定义一种数据类型涉及哪些内容?
答案
定义一种数据类型包括确定如何储存数据,以及设计管理该数据的一系列函数
(2)为什么程序清单17.2只能沿一个方向遍历链表? 如何修改 struct film 定义才能沿两个方向遍历链表?
答案
因为每个结构包含下一个结构的地址,但是不包含上一个结构的地址
所以这个链表只能沿一个方向遍历
可以修改结构,在结构中包含两个指针
一个指向上一个结构,一个指向下一个结构
程序也要添加代码,在每次新增结构时为这些指针赋正确的地址
(3)什么是 ADT?
答案
ADT 是抽象数据类型
是对一种类型的属性集和可以对该类型进行的操作的正式定义
ADT 应该用一般语言表示,而不是用某种特殊的计算机语言
而且不应该包含实现细节
(4)QueueIsEmpty() 函数接受一个指向 queue 结构的指针作为参数
但是也可以将其编写成接受一个 queue 结构作为参数
这两种方式各有什么优缺点?
答案
直接传递队列变量时,函数得到的是副本
不会改动原队列,也不需要使用地址运算符
缺点是必须分配空间复制整个结构,大型结构耗时且多占内存
传递地址时,函数直接访问原数据,更快且省内存
缺点是需要使用指针
旧式 C 中函数可能误改原数据
ANSI C 的 const 限定符可以防止这种情况
(5)栈是链表系列的另一种数据形式
在栈中,只能在链表的一端添加和删除项
项被压入栈和弹出栈
因此,栈是一种 LIFO 结构
a. 设计一个栈 ADT
b. 为栈设计一个 C 编程接口,例如 stack.h 头文件
答案
a. 类型名: 栈
类型属性: 可以储存有序项
类型操作: 初始化栈为空,确定栈是否为空,确定栈是否已满,从栈顶添加项,从栈顶删除项,清空栈
b. 下面以数组形式实现栈,结构定义属于实现细节,不影响函数原型
/* stack.h -- 栈的接口 */
#include <stdbool.h>
/* 在这里插入 Item 类型 */
/* 例如: typedef int Item; */

#define MAXSTACK 100

typedef struct stack
{
    Item items[MAXSTACK];
    int top;    /* 第 1 个空位的索引 */
} Stack;

void InitializeStack(Stack * ps);
bool FullStack(const Stack * ps);
bool EmptyStack(const Stack * ps);
bool Push(Item item, Stack * ps);
bool Pop(Item * pitem, Stack * ps);
(6)在一个含有 3 个项的分类列表中
判断一个特定项是否在该列表中
用顺序查找和二叉查找方法分别需要最多多少次?
当列表中有 1023 个项时分别是多少次?
65535 个项时分别是多少次?
答案
最大比较次数如下
表17-2 顺序查找与二分查找的最大比较次数
| 项数 | 顺序查找 | 二分查找 |
|---|---|---|
| 3 | 3 | 2 |
| 1023 | 1023 | 10 |
| 65535 | 65535 | 16 |
(7)假设一个程序用本章介绍的算法构造了一个储存单词的二叉查找树
假设根据下面所列的顺序输入单词,请画出每种情况的树:
a. nice food roam dodge gate office wave
b. wave roam office nice gate food dodge
c. food dodge roam wave office gate nice
d. nice roam office food wave gate dodge
答案
四种输入顺序对应的树见附录图A.1
(8)考虑复习题7构造的二叉树,根据本章的算法,删除单词 food 之后,各树是什么样子?
答案
删除 food 之后的各树见附录图A.2
编程练习
编程练习
-
修改程序清单17.2,让该程序既能正序也能逆序显示电影列表
一种方法是修改链表的定义,可以双向遍历链表
另一种方法是用递归 -
假设
list.h(程序清单17.3) 使用下面的list定义
重写list.c(程序清单17.5) 中的函数以适应新的定义
并通过films.c(程序清单17.4) 测试最终的代码
- 假设
list.h(程序清单17.3) 使用下面的list定义
重写list.c(程序清单17.5) 中的函数以适应新的定义
并通过films.c(程序清单17.4) 测试最终的代码
-
重写
mall.c(程序清单17.9),用两个队列模拟两个摊位 -
编写一个程序,提示用户输入一个字符串
然后该程序把该字符串的字符逐个压入一个栈 (参见复习题5)
再从栈中弹出这些字符,并显示它们
结果显示为该字符串的逆序 -
编写一个函数接受 3 个参数: 一个数组名 (内含已排序的整数),
该数组的元素个数和待查找的整数
如果待查找的整数在数组中,那么该函数返回 1
如果该数不在数组中,该函数则返回 0
用二分查找法实现 -
编写一个程序,打开和读取一个文本文件
并统计文件中每个单词出现的次数
用改进的二叉查找树储存单词及其出现的次数
程序在读入文件后,会提供一个有 3 个选项的菜单
第 1 个选项是列出所有的单词和出现的次数
第 2 个选项是让用户输入一个单词
程序报告该单词在文件中出现的次数
第 3 个选项是退出 -
修改宠物俱乐部程序,把所有同名的宠物都储存在同一个节点中
当用户选择查找宠物时,程序应询问用户该宠物的名字
然后列出该名字的所有宠物 (及其种类)