第13章 文件输入/输出
本页最后更新于 ,内容可能过时
文件指针与标准文件
示例
输出:
说明
FILE是stdio.h中定义的派生类型,结构由实现决定- 文件指针指向一个数据对象,其中记录缓冲区位置,已缓冲字节数,文件位置等信息
- 它不指向磁盘上的文件,文件名只在
fopen()时使用 - 程序启动时自动打开 3 个标准文件,见表13-1
- 标准 I/O 函数一律用文件指针指定流,不用文件名
表13-1 标准文件与文件指针
| 标准文件 | 文件指针 | 默认设备 |
|---|---|---|
| 标准输入 | stdin |
键盘 |
| 标准输出 | stdout |
显示器 |
| 标准错误 | stderr |
显示器 |
常见错误
- 把
fopen()的返回值存进int *或char * - 把文件名直接传给
fclose()或fputs() - 以为
stderr会随输出重定向一起写入文件
文本模式与二进制模式
说明
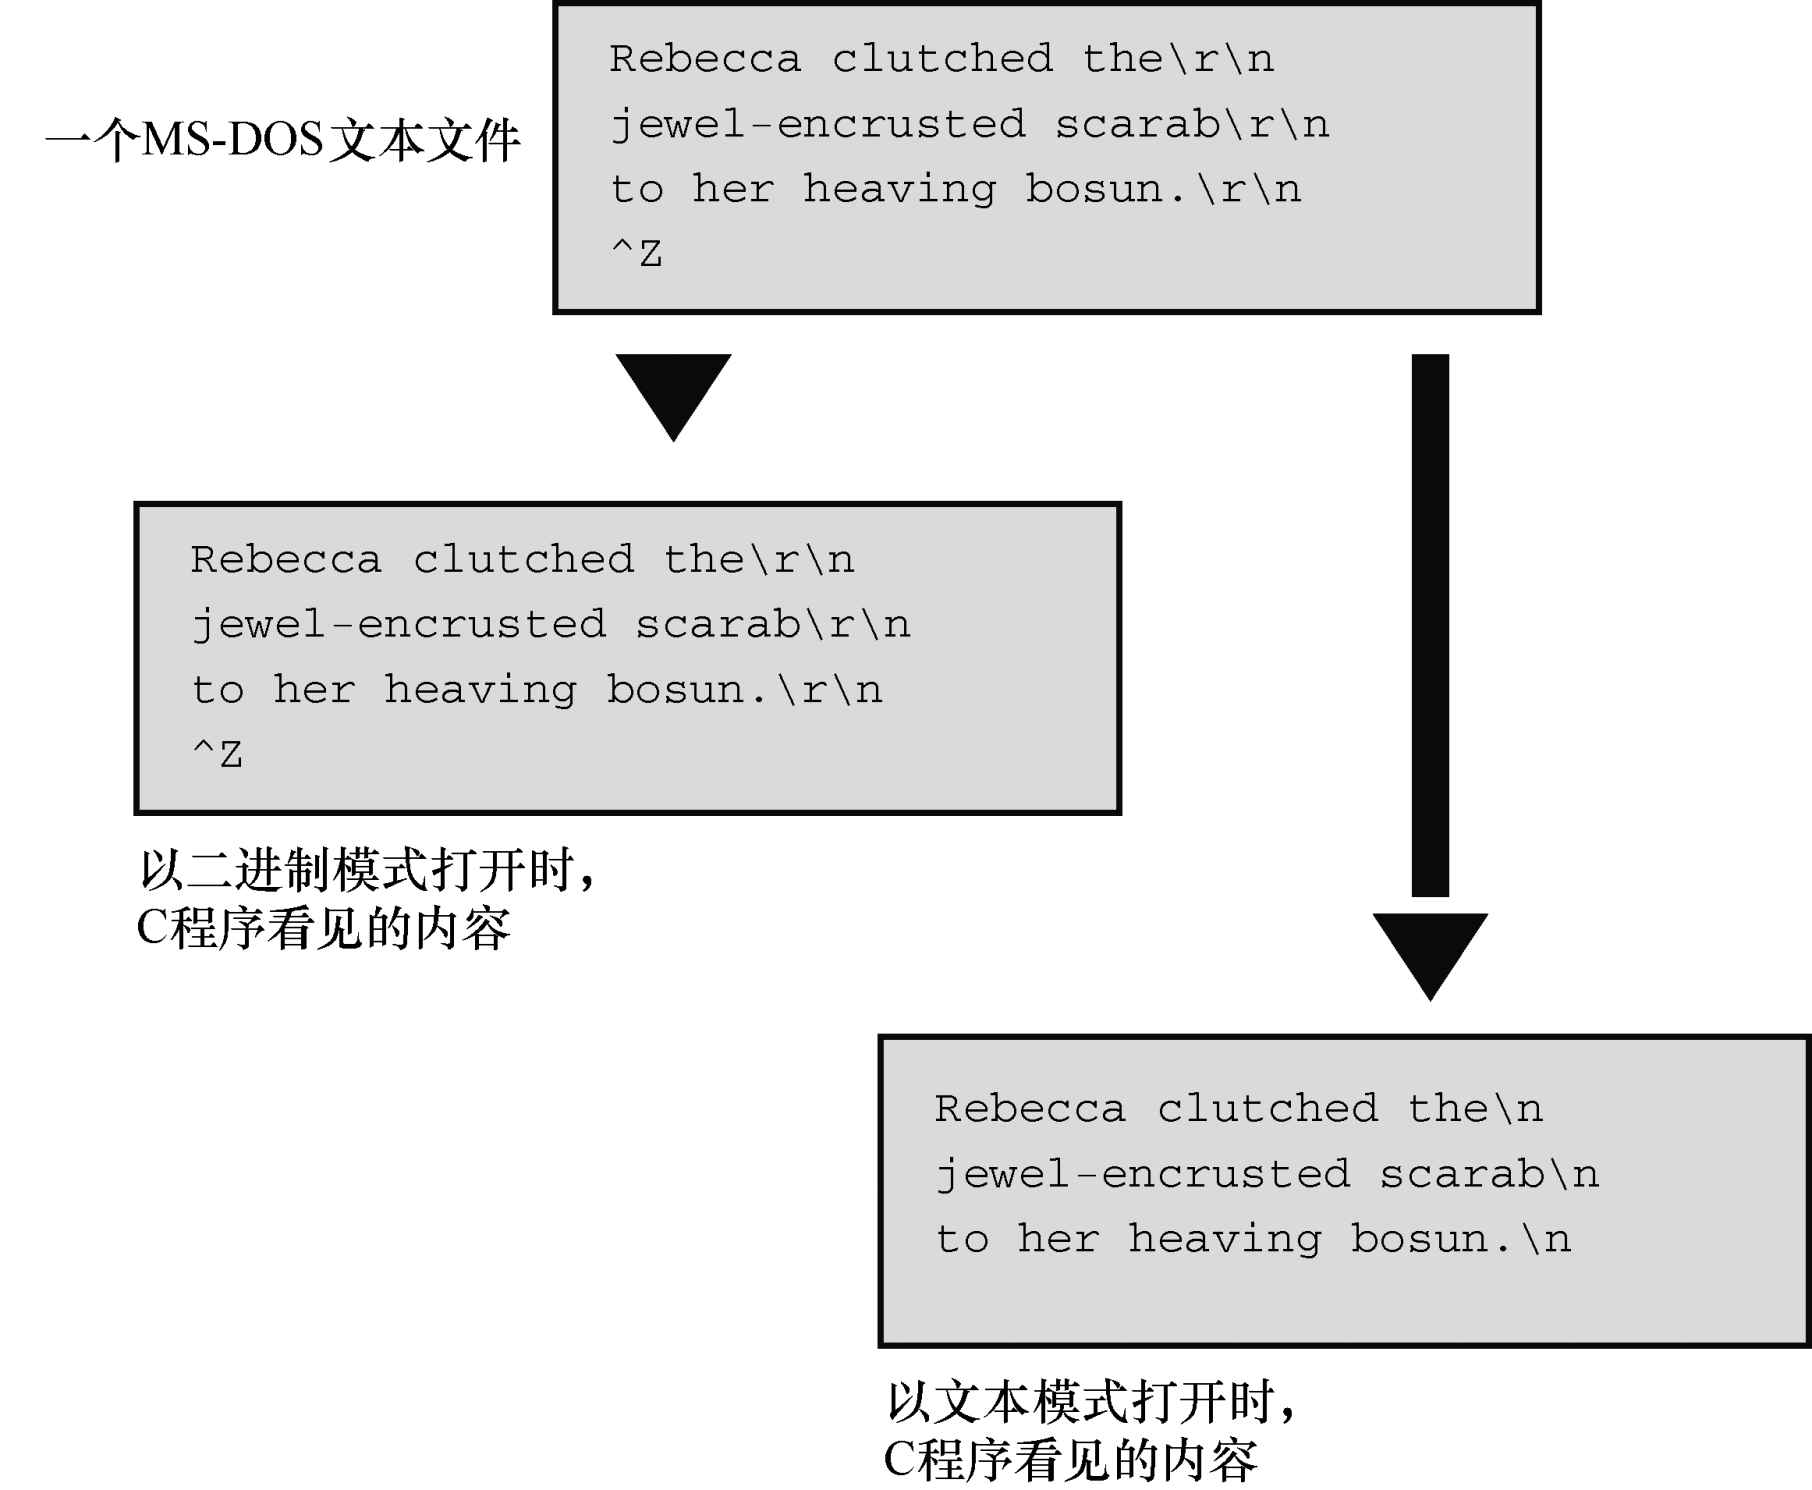
- 文件内容是字节序列,两种模式决定程序看到的字节与文件中的字节是否一致
- 二进制模式: 程序读到文件中的每一个字节,不做转换
- 文本模式: 程序把本地环境的行尾与文件结尾映射为 C 的表示法
- 写入时做反向映射
- 常见平台的映射见表13-2
- 某些 MS-DOS 文本文件用 Ctrl+Z (
'\032') 标记结尾 - 文本模式把这个字符当作文件结尾,二进制模式把它当作普通字节
- UNIX 与 Linux 只有一种文件格式,两种模式完全相同
- 需要逐字节定位或自己处理行尾时用二进制模式
表13-2 文本模式下的行尾映射
| 平台 | 文件中的行尾 | 读入后 | 写入 \n 时生成 |
|---|---|---|---|
| Windows,MS-DOS | \r\n |
\n |
\r\n |
| 旧版 Mac OS | \r |
\n |
\r |
| UNIX,Linux | \n |
\n |
\n |
常见错误
- 以为文本模式写入的换行一定占一个字节
- 在 Windows 上用文本模式统计字节数,结果小于文件实际大小
- 用文本模式读 MS-DOS 文件后,仍按
\r\n判断行尾
fopen() 的模式字符串
示例
#include <stdio.h>
#include <stdlib.h>
int main(void)
{
    FILE *fp = fopen("data.txt", "w");
    if (fp == NULL)
    {
        perror("data.txt");
        exit(EXIT_FAILURE);
    }
    fputs("ok\n", fp);
    fclose(fp);
    return 0;
}
输出:
说明
- 成功返回文件指针,失败返回
NULL - 文件名可以是相对路径或绝对路径
- Windows 路径中的反斜杠在 C 字符串里写作
\\ - 模式字符串见表13-3
- 更新模式带
+,可以读写 - 更新模式下输出后接输入,要先调用以下函数之一
fflush(),fseek(),fsetpos(),rewind() - 输入后接输出,要先调用
fseek(),fsetpos()或rewind() "r+"要求文件已存在,且不截断原内容
[教材表13.1 只写"可读写",未说明文件必须存在]"w+"在文件存在时截断为 0,不存在时创建"a+"的写入固定在末尾,读之前要先rewind()或fseek()- 模式中加
b为二进制模式,例如"rb","wb+" -
C11 的
x模式在文件已存在时打开失败,且不删除原文件 -
表13-3
fopen()的模式字符串
| 模式 | 文件存在 | 文件不存在 | 初始读写位置 |
|---|---|---|---|
"r" |
从开头读 | 打开失败 | 开头 |
"w" |
截断为 0 | 创建 | 开头 |
"a" |
保留,写在末尾 | 创建 | 末尾 |
"r+" |
从开头读写,不截断 | 打开失败 | 开头 |
"w+" |
截断为 0,可读写 | 创建 | 开头 |
"a+" |
保留,写在末尾,可读 | 创建 | 读在开头,写固定末尾 |
常见错误
- 用
"w"打开已有文件想追加,原内容被清空 - 用
"r+"打开不存在的文件,又不检查NULL - 不检查返回值就使用
fp - 在
"a+"下不rewind()就直接读
fclose() 函数
示例
#include <stdio.h>
int main(void)
{
    FILE *fp = fopen("data.txt", "w");
    if (fp == NULL)
        return 1;
    fputs("ok\n", fp);
    if (fclose(fp) != 0)
        puts("close error");
    return 0;
}
输出:
说明
- 成功返回
0,失败返回EOF - 关闭时刷新输出缓冲区,未写入的数据送入文件
- 磁盘已满,存储设备被移除,出现 I/O 错误都会使关闭失败
- 程序正常结束或调用
exit()时,所有打开的流会被关闭 - 同时打开的文件数由实现决定,常见范围是 10 到 20
- 同一个文件指针可以先后处理不同的文件,只要这些文件不同时打开
常见错误
- 忘记关闭文件,缓冲区中的内容没有写入
- 对同一个指针调用两次
fclose() - 只检查
fopen()不检查fclose(),写满磁盘时仍以为成功
getc() 与 putc()
示例
#include <stdio.h>
int main(void)
{
    FILE *fp = fopen("a.txt", "r");
    int ch, n = 0;
    if (fp == NULL)
        return 1;
    while ((ch = getc(fp)) != EOF)
    {
        putc(ch, stdout);
        n++;
    }
    fclose(fp);
    printf("\n%d\n", n);
    return 0;
}
输出:
说明
getc()返回读到的字符,值在unsigned char范围内,或返回EOFputc()返回写入的字符,出错返回EOFgetc(stdin)与getchar()等价putc(ch, stdout)与putchar(ch)等价getc()通常实现为宏,fgetc()是函数,行为相同- 字符以
int类型传递,便于表示EOF
常见错误
- 用
char接收getc()的返回值,无法区分EOF与字节0xFF - 把文件指针放在
putc()的第 1 个参数
文件结尾与读取循环
示例
#include <stdio.h>
int main(void)
{
    FILE *fp = fopen("a.txt", "r");
    int ch;
    if (fp == NULL)
        return 1;
    while ((ch = getc(fp)) != EOF)
        putchar(ch);
    fclose(fp);
    return 0;
}
输出:
说明
- C 的输入函数在读过文件末尾之后才返回
EOF - 因此要先读,再判断,用入口条件循环
- 不要用
do while循环读文件,空文件会先处理一次 fgets()到末尾返回NULL,fscanf()读前已到末尾返回EOFfscanf()的返回值是成功赋值的项数- 同一套写法适用于所有返回
EOF或NULL的输入函数
常见错误
- 循环前未给
ch赋值就比较ch != EOF - 在循环体里先读后处理,把
EOF当字符输出 - 用
char类型保存读入的字符
fprintf() 与 fscanf()
示例
#include <stdio.h>
int main(void)
{
    char word[20];
    FILE *fp = fopen("wordy", "a+");
    if (fp == NULL)
        return 1;
    fprintf(fp, "%s\n", "hello");
    rewind(fp);
    while (fscanf(fp, "%19s", word) == 1)
        puts(word);
    fclose(fp);
    return 0;
}
输出:
说明
- 用法与
printf(),scanf()相同,多一个文件指针参数 - 文件指针是第 1 个参数,而
putc()的文件指针在最后 fprintf()返回写入的字符数,出错返回负值fscanf()返回成功赋值的项数,读前已到末尾返回EOF%s要限制宽度,例如%19s,防止越界rewind(fp)把位置移回开头,并清除文件结尾与错误标志
常见错误
- 写成
fprintf("%d\n", n, fp),把文件指针放到最后 - 不检查
fscanf()的返回值,读到旧数据继续使用 - 用
"a+"写入后不rewind()就读
fgets() 与 fputs()
示例
#include <stdio.h>
int main(void)
{
    char line[81];
    FILE *fp = fopen("a.txt", "r");
    if (fp == NULL)
        return 1;
    while (fgets(line, 81, fp) != NULL)
        fputs(line, stdout);
    fclose(fp);
    return 0;
}
输出:
说明
fgets()最多读n-1个字符,再在末尾补'\0'- 遇到换行符就停止,并把换行符存入缓冲区
- 到文件末尾或读出错时返回
NULL fputs()写入字符串,不在末尾添加换行符puts()会在末尾添加换行符,与fgets()配合会产生空行- 读整行时
n取行长加 1
常见错误
- 把
n写成字符数,实际最多只读n-1个 - 用
puts()输出fgets()读到的行,每行多一个空行 - 不检查
fgets()是否返回NULL就处理缓冲区
fseek() 与 ftell()
示例
#include <stdio.h>
int main(void)
{
    FILE *fp = fopen("a.txt", "rb");
    if (fp == NULL)
        return 1;
    fseek(fp, 0L, SEEK_END);     /* 移到文件末尾 */
    printf("%ld\n", ftell(fp));  /* 文件字节数 */
    fseek(fp, -1L, SEEK_END);    /* 回退 1 字节 */
    putchar(getc(fp));
    putchar('\n');
    fclose(fp);
    return 0;
}
输出:
说明
offset是long类型,可取正,负或 0- 起始点由第 3 个参数决定,见表13-4
- 成功返回
0,失败返回非零值
[标准只要求非零,具体值由实现决定,常见为 -1] ftell()返回当前位置距文件开头的字节数- 只有二进制模式下
ftell()的值才等于字节偏移 - 文本模式下可移植的调用只有 4 种
fseek(fp, 0L, SEEK_SET),移到开头fseek(fp, 0L, SEEK_CUR),位置不变fseek(fp, 0L, SEEK_END),移到末尾fseek(fp, ftell位置, SEEK_SET),回到ftell()记录的位置-
二进制模式不要求支持
SEEK_END -
表13-4
fseek()的起始点
| 常量 | 偏移量的起始点 |
|---|---|
SEEK_SET |
文件开头 |
SEEK_CUR |
当前位置 |
SEEK_END |
文件末尾 |
常见错误
- 在文本模式下用
ftell()的差值计算记录位置 - 越过文件末尾的
fseek()仍返回0,随后的读操作失败 - 不检查返回值,定位失败后照常读取
- 把
ftell()的返回值存进int,大文件上被截断
fgetpos() 与 fsetpos()
示例
#include <stdio.h>
int main(void)
{
    FILE *fp = fopen("a.txt", "rb");
    fpos_t pos;
    int c;
    if (fp == NULL)
        return 1;
    fgetpos(fp, &pos);       /* 记录当前位置 */
    c = getc(fp);
    fsetpos(fp, &pos);       /* 回到记录的位置 */
    printf("%c %c\n", c, getc(fp));
    fclose(fp);
    return 0;
}
输出:
说明
fpos_t能表示超出long范围的文件位置fpos_t可能是结构类型,不能是数组- 只能把
fgetpos()保存的值交给fsetpos() - 两个函数成功返回
0,失败返回非零值 - 实现可以把
fpos_t定义成满足平台要求的任意类型
常见错误
- 自己给
fpos_t变量赋值或直接打印 - 把一个文件记录的
fpos_t值用于另一个文件
fread() 与 fwrite()
语法形式
示例
#include <stdio.h>
int main(void)
{
    double a[3] = {1.5, 2.5, 3.5}, b[3];
    FILE *fp = fopen("d.dat", "wb");
    if (fp == NULL)
        return 1;
    fwrite(a, sizeof(double), 3, fp);
    fclose(fp);
    fp = fopen("d.dat", "rb");
    fread(b, sizeof(double), 3, fp);
    fclose(fp);
    printf("%.1f %.1f %.1f\n", b[0], b[1], b[2]);
    return 0;
}
输出:
说明
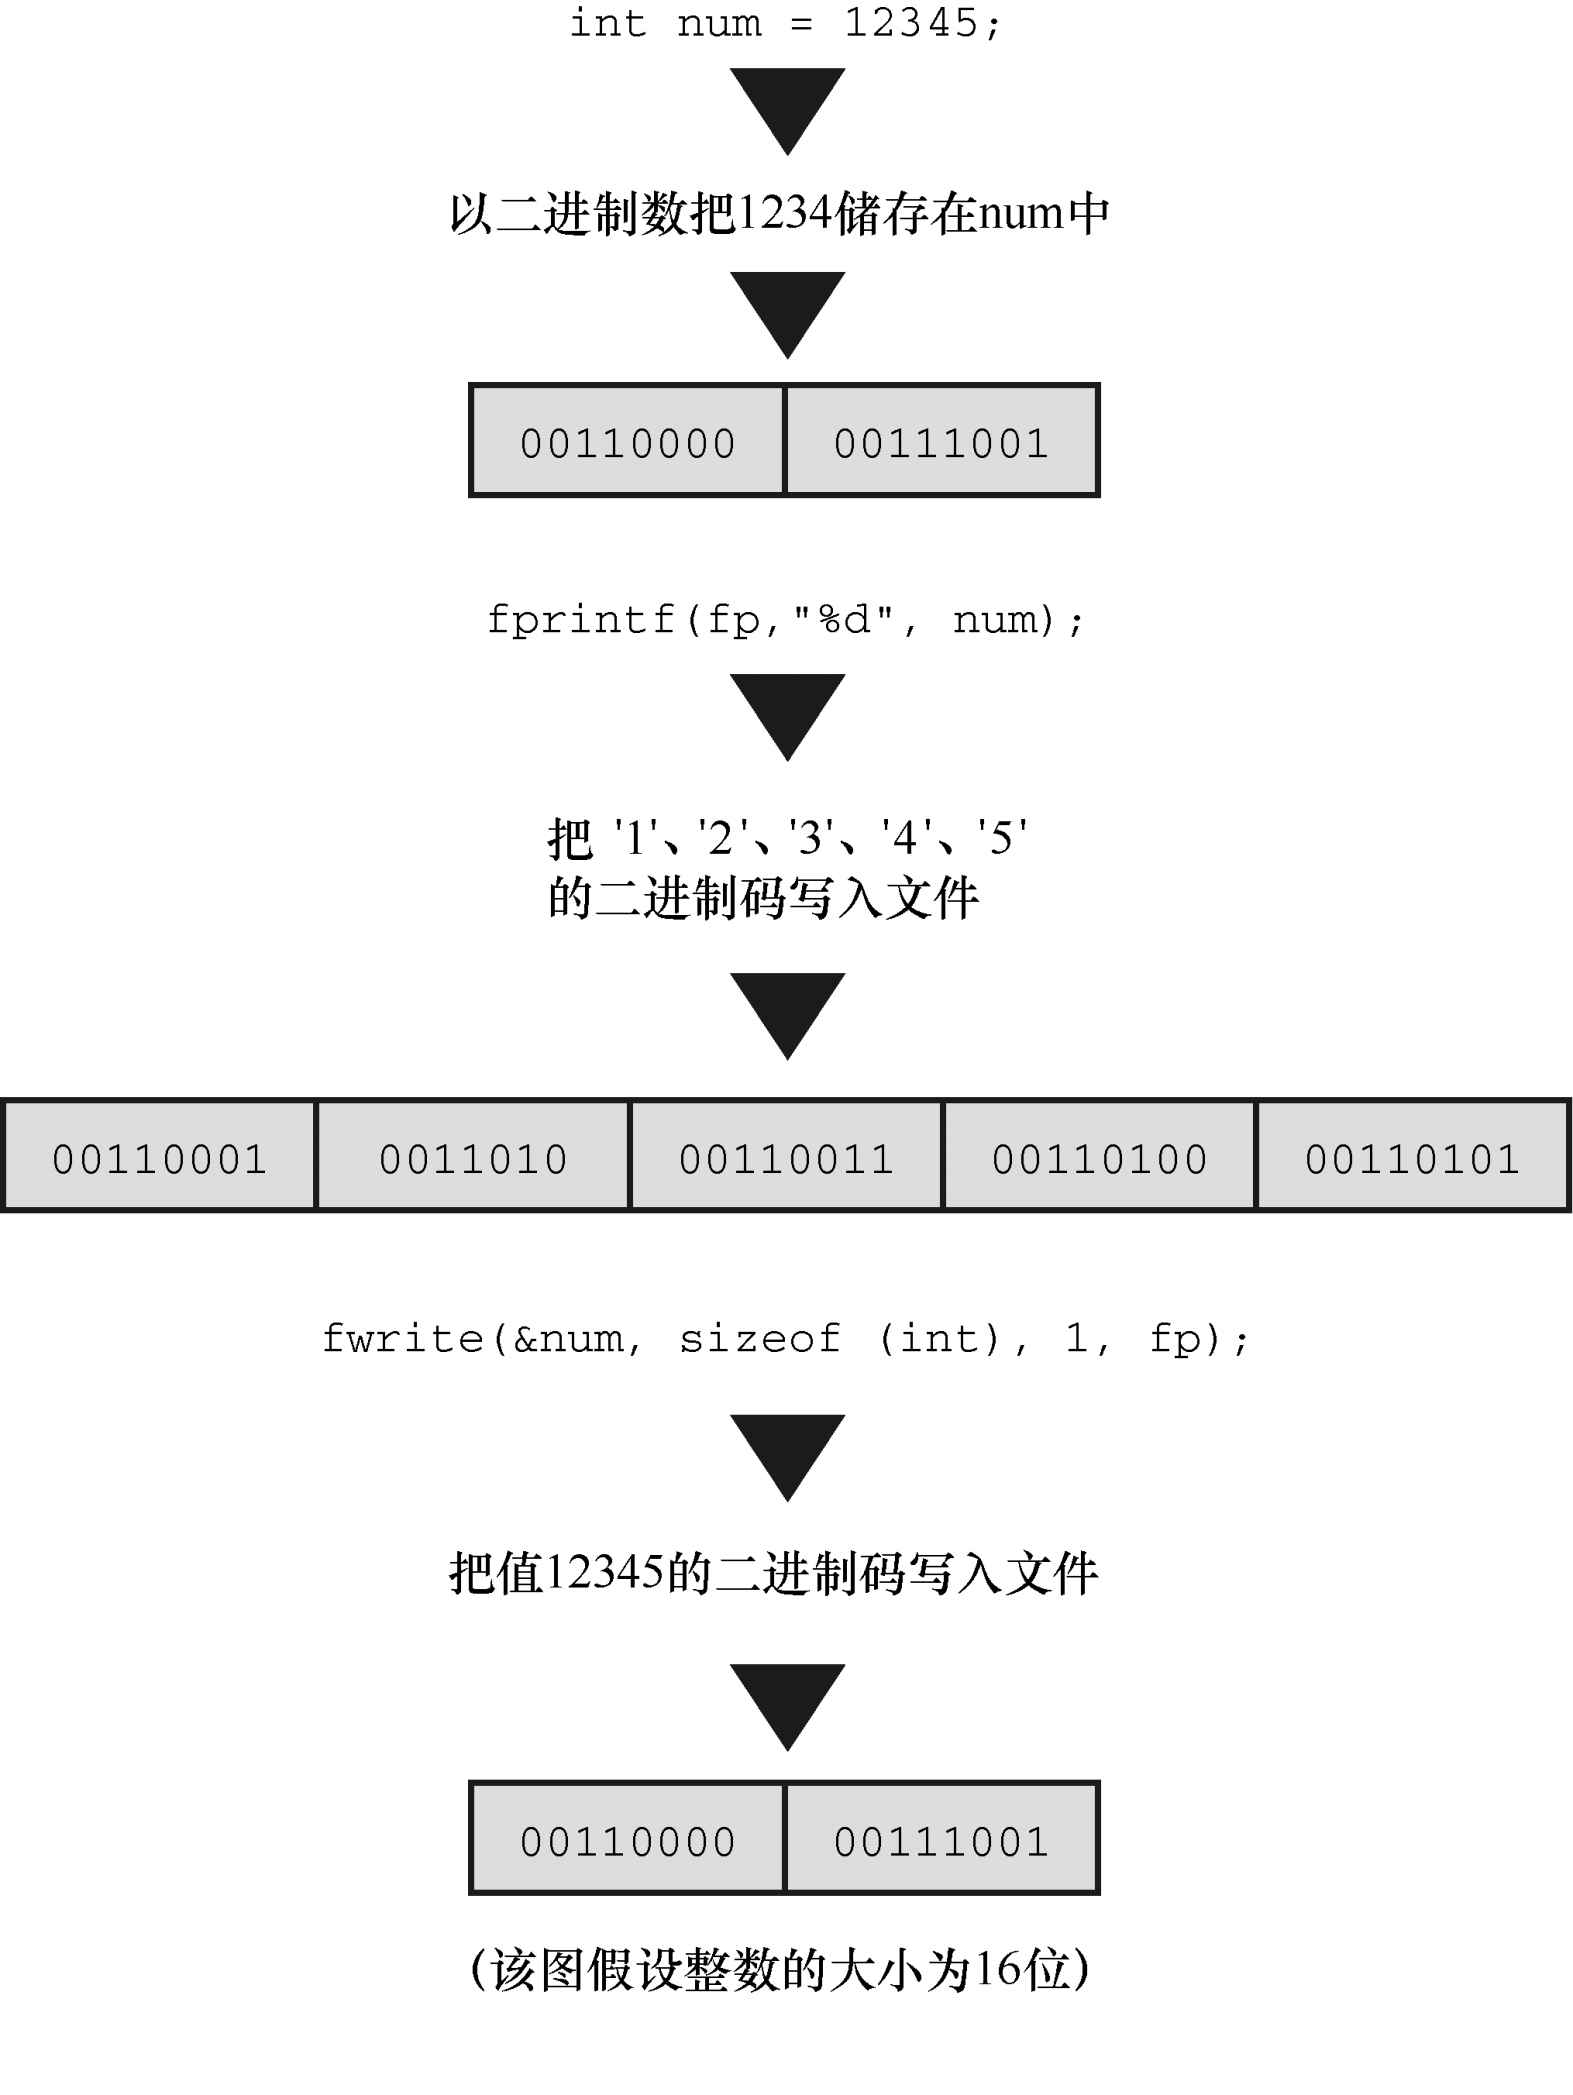
- 按内存中的位组合写入,不做数值到字符串的转换
- 读取前后数值完全相同,没有精度损失
- 返回值是完整读写的项数
- 读取项数小于
nmemb时,用feof()与ferror()判断原因 ptr是void *,可接收任意类型的数组地址- 二进制文件不能用文本编辑器查看
- 二进制格式与字节序,类型宽度有关,不能直接跨平台使用
常见错误
- 把
size与nmemb的顺序写反 - 忽略返回值,把不完整的记录当完整记录使用
- 用
fprintf("%f")保存数值,读回时精度已经丢失 - 在一台机器上写,在另一台机器上直接读
feof() 与 ferror()
示例
#include <stdio.h>
int main(void)
{
    FILE *fp = fopen("a.txt", "r");
    int ch;
    if (fp == NULL)
        return 1;
    while ((ch = getc(fp)) != EOF)
        putchar(ch);
    if (ferror(fp))
        puts("read error");
    else if (feof(fp))
        puts("end of file");
    fclose(fp);
    return 0;
}
输出:
说明
- 输入函数返回
EOF与NULL时,可能是文件末尾,也可能是读错误 feof()在读取越过末尾的那次调用之后才返回非零- 读到最后一个字节时
feof()仍返回0 ferror()在读写出错后返回非零,否则返回0- 两个标志由
clearerr()清除
[教材 13.6 节称读完最后一个字符就置位结尾指示器,与标准不符
置位发生在下一次读取尝试失败时]
常见错误
- 用
while (!feof(fp))作循环条件,多处理一行或一次旧数据 - 用
ferror()检查文件是否存在 - 一次读到
EOF后不调用clearerr()就重试
ungetc() 函数
示例
#include <stdio.h>
int main(void)
{
    FILE *fp = fopen("k.txt", "r");
    int ch;
    if (fp == NULL)
        return 1;
    while ((ch = getc(fp)) != ':')   /* k.txt 为 key:value */
        putchar(ch);
    if (ch != EOF)
        ungetc(ch, fp);              /* 把冒号放回 */
    printf("\nnext=%c\n", getc(fp));
    fclose(fp);
    return 0;
}
输出:
说明
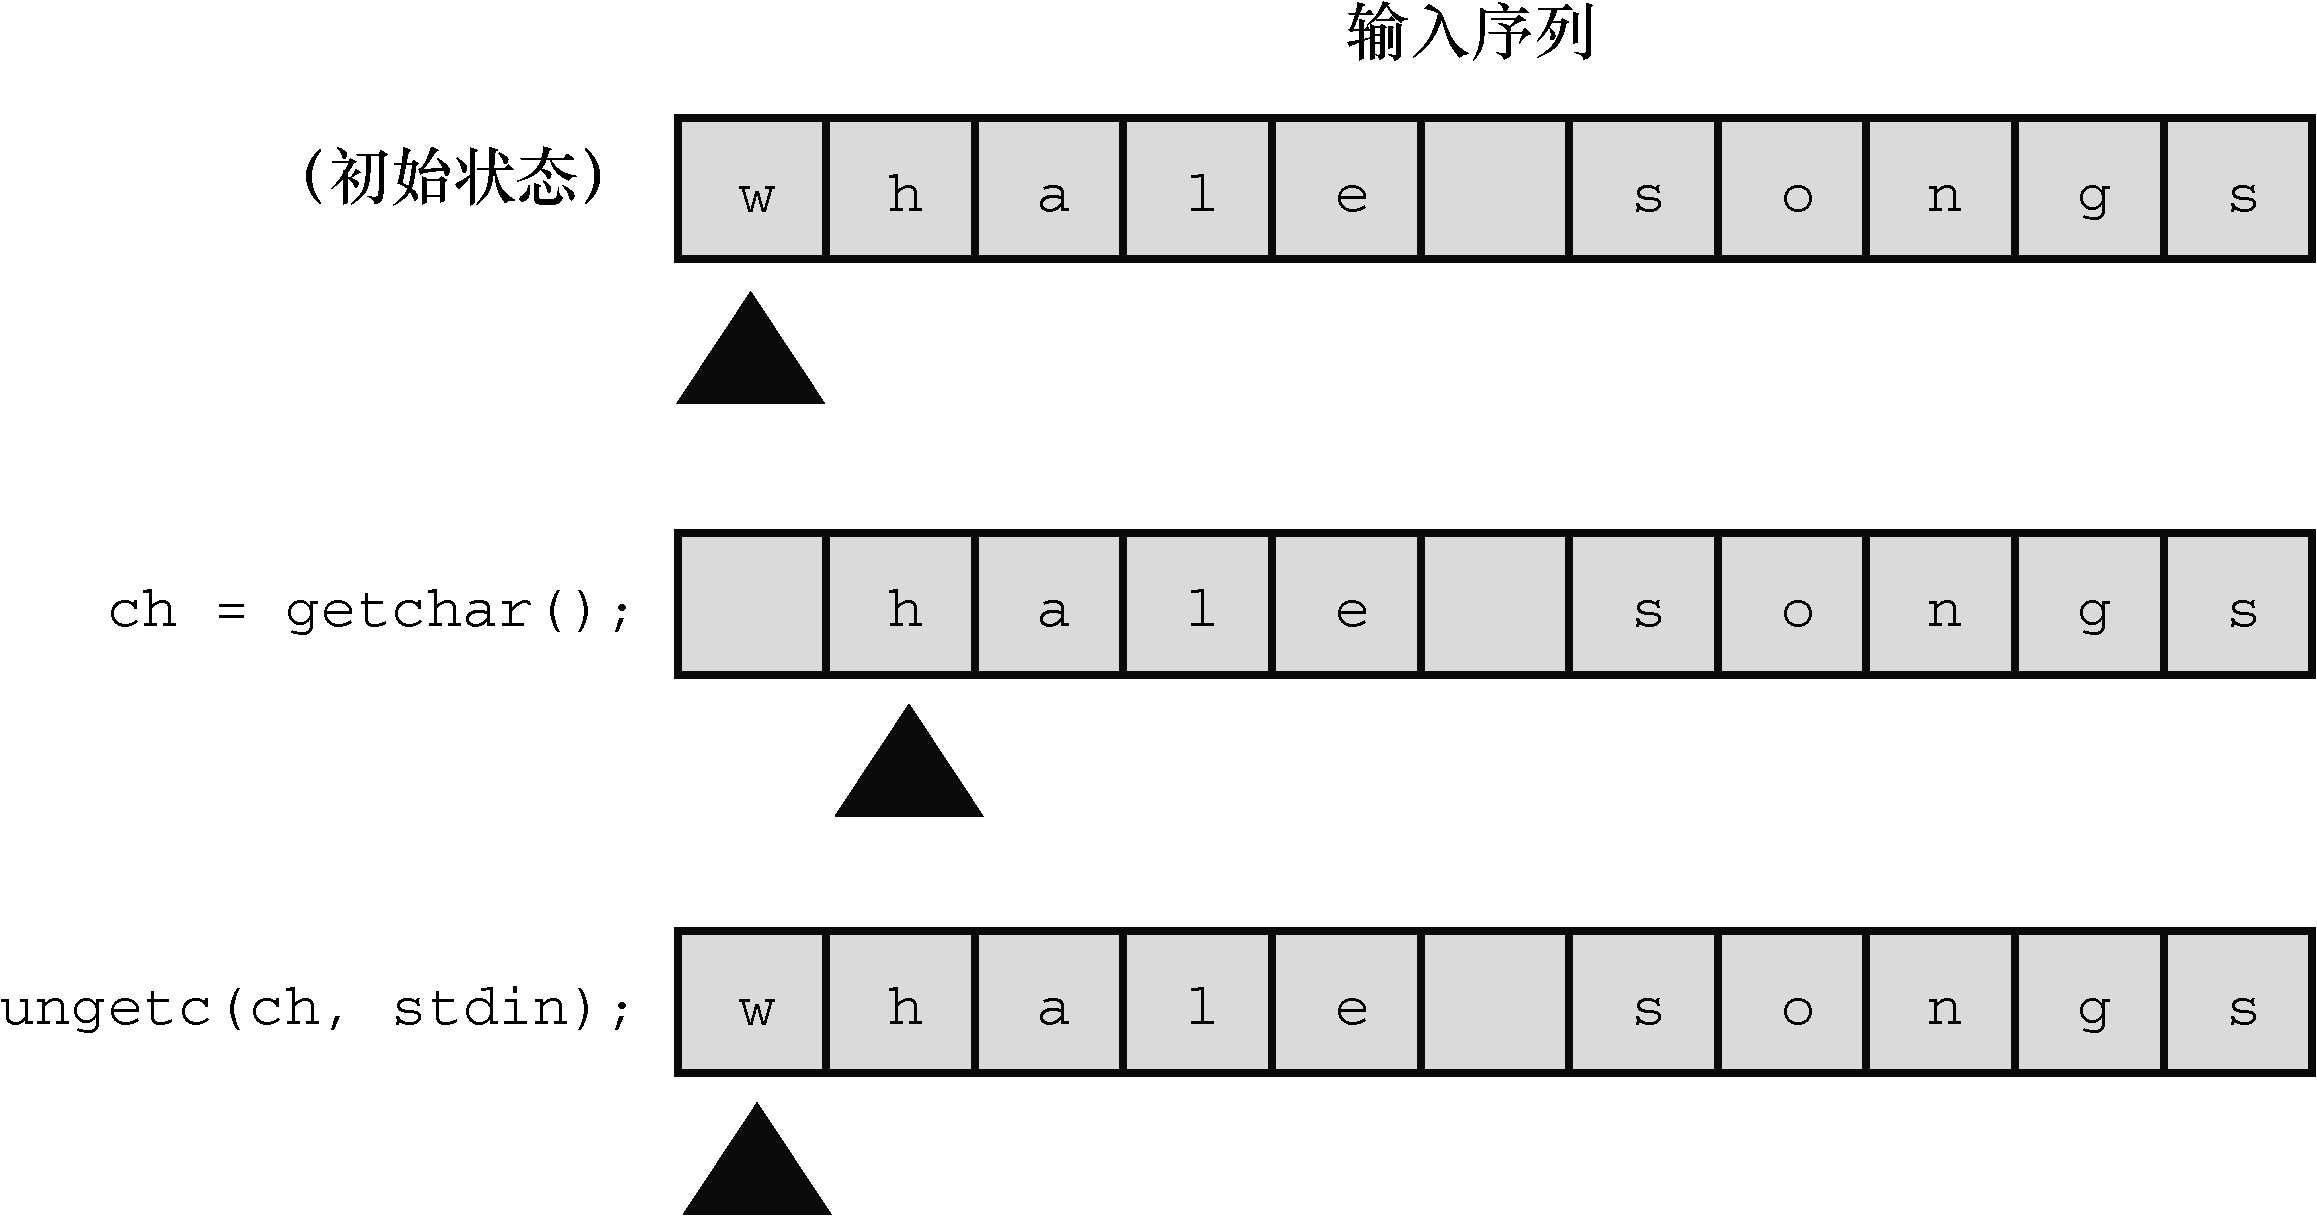
- 把字符放回输入流,下一次输入函数先读到它
- 标准只保证能放回 1 个字符
- 实现允许多次放回时,读出顺序与放回顺序相反
- 不能放回
EOF - 放回成功后清除文件结尾标志
常见错误
- 依赖连续放回多个字符
- 放回后按原来的读取位置推算后续字符
fflush() 函数
示例
#include <stdio.h>
int main(void)
{
    FILE *fp = fopen("log.txt", "w");
    if (fp == NULL)
        return 1;
    fputs("working", fp);    /* 数据在缓冲区中 */
    fflush(fp);              /* 立即写入文件 */
    getchar();               /* 等待期间文件已有内容 */
    fclose(fp);
    return 0;
}
输出:
说明
- 把输出缓冲区中未写入的数据送入文件
- 参数为
NULL时刷新所有输出流 - 在输入流上使用是未定义行为
- 对更新流,最近一次操作不是输入时可以使用
- 终端上的行缓冲流在写入换行符时自动刷新
常见错误
- 用
fflush(stdin)清空输入缓冲区,该用法不可移植 - 以为
fflush()会关闭文件 - 不刷新就等待其他程序读取文件
setvbuf() 函数
示例
#include <stdio.h>
int main(void)
{
    FILE *fp = fopen("buf.txt", "w");
    if (fp == NULL)
        return 1;
    if (setvbuf(fp, NULL, _IOFBF, 4096) != 0)
        return 2;
    fputs("buffered\n", fp);
    fclose(fp);
    return 0;
}
输出:
说明
- 为流指定新的缓冲区
- 必须在
fopen()之后,其他操作之前调用 buf为NULL时由库分配缓冲区buf不为NULL时必须指向足够大的存储区size是缓冲区的字节数- 缓冲模式见表13-5
-
成功返回
0,失败返回非零值 -
表13-5
setvbuf()的缓冲模式
| 模式 | 含义 |
|---|---|
_IOFBF |
全缓冲,缓冲区满时刷新 |
_IOLBF |
行缓冲,缓冲区满或写入换行符时刷新 |
_IONBF |
无缓冲 |
常见错误
- 在读写之后再调用
setvbuf() - 传入的缓冲区是局部数组,函数返回前就失效
- 把
mode写成数值 0、1、2
二进制文件的随机访问
示例
#include <stdio.h>
#define N 100
int main(void)
{
    double a[N], v;
    FILE *fp;
    int i;
    for (i = 0; i < N; i++)
        a[i] = i + 0.5;
    fp = fopen("n.dat", "wb");
    fwrite(a, sizeof(double), N, fp);
    fclose(fp);
    fp = fopen("n.dat", "rb");
    fseek(fp, 3L * sizeof(double), SEEK_SET);
    fread(&v, sizeof(double), 1, fp);
    printf("%f\n", v);
    fclose(fp);
    return 0;
}
输出:
说明
- 定长记录的文件可以看作数组,第
index个记录的位置是index乘记录长度 - 偏移量用
long,计算时把下标转成long - 每个
double占 64 位,位置可以直接算出 - 文件要以
"rb"或"wb"打开,偏移量才是字节数 - 读取时不用转换说明,
fread()按字节拷贝到目标地址
常见错误
- 用文本模式打开文件后按字节偏移定位
- 记录长度按字符串长度计算
- 写入用
float,读取用double - 忘记乘以
sizeof(类型)
复习题
(1)下面的程序有什么问题?
int main(void)
{
    int * fp;
    int k;
    fp = fopen("gelatin");
    for (k = 0; k < 30; k++)
        fputs(fp, "Nanette eats gelatin.");
    fclose("gelatin");
    return 0;
}
答案
缺少 #include <stdio.h>
fp 应声明为 FILE *
fopen() 缺少模式参数,应写 fopen("gelatin", "w")
fputs() 的两个参数顺序反了
fclose() 要接收文件指针,不是文件名
输出字符串末尾加 \n,提高可读性
修改后的程序
(2)下面的程序完成什么任务? (假设在命令行环境中运行)
#include <stdio.h>
#include <stdlib.h>
#include <ctype.h>
int main(int argc, char *argv [])
{
    int ch;
    FILE *fp;
    if (argc < 2)
        exit(EXIT_FAILURE);
    if ((fp = fopen(argv[1], "r")) == NULL)
        exit(EXIT_FAILURE);
    while ((ch = getc(fp)) != EOF)
        if (isdigit(ch))
            putchar(ch);
    fclose(fp);
    return 0;
}
答案
打开命令行第 1 个参数指定的文件,逐个显示其中的数字字符
(3)假设程序中有下列语句
另外,假设成功打开了两个文件,补全下面函数调用中缺少的参数
a.
ch = getc();b.
fprintf( ,"%c\n", );c.
putc( , );d.
fclose(); /* 关闭 terky 文件 */
答案
a. ch = getc(fp1);
b. fprintf(fp2, "%c\n", ch);
c. putc(ch, fp2);
d. fclose(fp1);
fp1 识别以读模式打开的文件,用于输入
fp2 以写模式打开,用于输出
(4)编写一个程序,不接受任何命令行参数或接受一个命令行参数
如果有一个参数,将其解释为文件名
如果没有参数,使用标准输入 (stdin) 作为输入
假设输入完全是浮点数
该程序要计算和报告输入数字的算术平均值
答案
#include <stdio.h>
#include <stdlib.h>

int main(int argc, char * argv [])
{
    FILE * fp;
    double n;
    double sum = 0.0;
    int ct = 0;

    if (argc == 1)
        fp = stdin;
    else if (argc == 2)
    {
        if ((fp = fopen(argv[1], "r")) == NULL)
        {
            fprintf(stderr, "Can't open %s\n", argv[1]);
            exit(EXIT_FAILURE);
        }
    }
    else
    {
        fprintf(stderr, "Usage: %s [filename]\n", argv[0]);
        exit(EXIT_FAILURE);
    }
    while (fscanf(fp, "%lf", &n) == 1)
    {
        sum += n;
        ct++;
    }
    if (ct > 0)
        printf("Average of %d values = %f\n", ct, sum / ct);
    else
        printf("No valid data.\n");

    return 0;
}
(5)编写一个程序,接受两个命令行参数
第 1 个参数是字符,第 2 个参数是文件名
要求该程序只打印文件中包含给定字符的那些行
C 程序根据 '\n' 识别文件中的行
假设所有行都不超过 256 个字符,可以用 fgets()
答案
#include <stdio.h>
#include <stdlib.h>
#define BUF 256
int has_ch(char ch, const char * line);
int main(int argc, char * argv [])
{
    FILE * fp;
    char ch;
    char line[BUF];

    if (argc != 3)
    {
        printf("Usage: %s character filename\n", argv[0]);
        exit(EXIT_FAILURE);
    }
    ch = argv[1][0];
    if ((fp = fopen(argv[2], "r")) == NULL)
    {
        printf("Can't open %s\n", argv[2]);
        exit(EXIT_FAILURE);
    }
    while (fgets(line, BUF, fp) != NULL)
    {
        if (has_ch(ch, line))
            fputs(line, stdout);
    }
    fclose(fp);
    return 0;
}
int has_ch(char ch, const char * line)
{
    while (*line)
        if (ch == *line++)
            return(1);
    return 0;
}
fgets() 与 fputs() 要一起使用
fgets() 会把换行符留在字符串中
fputs() 与 puts() 不同,不添加换行符
(6)二进制文件和文本文件有何区别? 二进制流和文本流有何区别?
答案
二进制文件与文本文件的区别在于格式对系统的依赖性
二进制流与文本流的区别在于读写时是否做转换
二进制流不转换,文本流可能转换换行符和其他字符
(7)a. 分别用 fprintf() 和 fwrite() 储存 8238201 有何区别?
b. 分别用 putc() 和 fwrite() 储存字符 S 有何区别?
答案
a. fprintf() 把它当作 7 个字符,占用 7 个字节
fwrite() 使用该数的二进制表示,储存为一个 4 字节的整数
b. 没有区别,两个函数都把它储存为一个单字节的二进制码
(8)下面语句的区别是什么?
printf("Hello, %s\n", name);
fprintf(stdout, "Hello, %s\n", name);
fprintf(stderr, "Hello, %s\n", name);
答案
第 1 条是第 2 条的简写
第 3 条把消息写到标准错误
标准错误通常输出到与标准输出相同的位置
但标准错误不受标准输出重定向的影响
(9)"a+","r+" 和 "w+" 模式打开的文件都是可读写的
哪种模式更适合用来更改文件中已有的内容?
答案
"r+" 最合适
"a+" 只允许在文件末尾添加内容
"w+" 提供一个空文件,丢弃原内容
编程练习
编程练习
-
修改程序清单13.1中的程序
要求提示用户输入文件名,并读取用户输入的信息,不使用命令行参数 -
编写一个文件拷贝程序
该程序通过命令行获取原始文件名和拷贝文件名
尽量使用标准 I/O 和二进制模式 -
编写一个文件拷贝程序,提示用户输入文本文件名
并以该文件名作为原始文件名和输出文件名
该程序使用ctype.h中的toupper()
在写入输出文件时把所有文本转换成大写
使用标准 I/O 和文本模式 -
编写一个程序,按顺序在屏幕上显示命令行中列出的所有文件
使用argc控制循环 -
修改程序清单13.5中的程序,用命令行界面代替交互式界面
-
使用命令行参数的程序依赖用户正确地使用参数
重写程序清单13.2中的程序,不使用命令行参数,改为提示用户输入所需信息 -
编写一个程序打开两个文件,可以使用命令行参数或提示用户输入文件名
a. 按这样的顺序打印: 第 1 个文件的第 1 行,第 2 个文件的第 1 行
第 1 个文件的第 2 行,第 2 个文件的第 2 行,以此类推
打印到行数较多文件的最后一行
b. 修改该程序,把行号相同的行打印成一行
-
编写一个程序,以一个字符和任意文件名作为命令行参数
如果字符后面没有参数,该程序读取标准输入
否则依次打开每个文件,报告每个文件中该字符出现的次数
文件名和字符本身也要一同报告
程序要检查参数数量是否正确,文件能否打开
无法打开某个文件时报告这一情况,然后继续处理下一个文件 -
修改程序清单13.3中的程序
从 1 开始,按加入列表的顺序为每个单词编号
程序下次运行时,新的单词编号接着上次的编号开始 -
编写一个程序打开一个文本文件,通过交互方式获得文件名
通过一个循环提示用户输入一个文件位置
程序打印从该位置开始到下一个换行符之前的内容
用户输入负数或非数值字符时结束输入循环 -
编写一个程序,接受两个命令行参数
第 1 个参数是字符串,第 2 个参数是文件名
程序查找该文件,打印包含该字符串的所有行
任务面向行而不是面向字符,使用fgets()而不是getc()
用strstr()在每一行中查找指定字符串
假设所有行都不超过 255 个字符 -
创建一个文本文件,内含 20 行,每行 30 个整数
整数在0到9之间,用空格分开
该文件用数字表示一张图片,0到9表示逐渐增加的灰度
编写程序把内容读入一个 20×30 的int数组
再用数组中的值初始化一个 20×31 的字符数组
值0对应空格,值1对应点字符,依此类推
数字越大,对应的字符占用的空间越大,值9用#表示
每行的最后一个字符是空字符,使该数组包含 20 个字符串
最后显示这张图片,并把结果储存到文本文件中 -
用变长数组 (VLA) 代替标准数组,完成编程练习 12
-
数字图像可能包含失真
为编程练习 12 添加消除失真的函数
函数把每个值与上下左右相邻的值比较
如果该值与周围相邻值的差都大于 1
用相邻值的平均值 (四舍五入为整数) 代替该值
边界上的点相邻的点少于 4 个,需要特殊处理